Qwen, DeepSeek или GigaChat: как выбрать модель под свою задачу и проверить выбор за неделю
Публичный рейтинг отвечает на вопрос, какая модель сильнее вообще. Вам нужен ответ на другой: какая из трёх-четырёх допустимых моделей лучше справится с вашими регламентами, договорами и обращениями сотрудников. Разбираем процедуру на одну рабочую неделю — тестовый набор из реальных вопросов, слепую оценку и разбор ошибок, которые дорого обходятся именно вам.
Коротко
Публичные рейтинги годятся, чтобы составить список кандидатов. Выбрать по ним модель для своей задачи нельзя: их собирают на чужих вопросах, чужих документах и по чужим критериям ошибки.
Выбор делается на своих данных за рабочую неделю. Два дня уходят на тестовый набор из 50–100 реальных вопросов, день на прогон всех кандидатов на одном стенде, день на слепую оценку двумя экспертами, день на разбор.
Главное: решение принимают по ошибкам, которые критичны для бизнеса, а не по среднему баллу. Модель, которая чаще других отвечает правильно, но уверенно выдумывает пункты регламентов, проигрывает модели поскромнее, которая честно говорит «в документах этого нет».
Обычно выбор модели происходит так. Архитектор приносит на совещание свежую таблицу рейтинга, где лидирует одна из открытых моделей. Кто-то вспоминает, что у коллег в соседнем холдинге «хорошо пошёл» GigaChat. Руководитель ИБ напоминает, что выбирать можно только среди того, что разворачивается в контуре. Через час решение принято, и побеждает аргумент, который прозвучал увереннее.
Через два месяца пилота выясняется, что модель путает действующую и прошлую редакции регламента, а на вопросы, ответа на которые в архиве нет, пишет правдоподобный текст со ссылкой на пункт, где об этом ни слова. Смена модели на этом этапе означает перенастройку запросов под другое поведение, повторное тестирование и повторную приёмку.
Материал для ИТ-директоров, архитекторов и руководителей проектов, которым предстоит решить, какую LLM выбрать для компании: для поиска по документам, работы с договорами или внутреннего ассистента. Обзор рынка и характеристики моделей собраны в сравнении отечественных LLM, с него удобно начинать список кандидатов. Спор открытых и коммерческих моделей разобран в отдельном материале. Здесь — методика: как проверить кандидатов на своих документах и не обмануться средним баллом.
Почему рейтинги не предсказывают качество на ваших документах
Рейтинг — честный замер. Только замер чужой задачи.
Другой язык. Открытые наборы для оценки моделей на русском существуют и развиваются. В конце августа 2026 года вышла вторая версия текстового набора MERA: двенадцать тестов, сгруппированных по навыкам — следование инструкциям, рассуждения, знание культурного контекста, работа с инструментами. Эталонные ответы закрыты, чтобы модели не выучили их при обучении. В сентябре Яндекс вместе с открытой базовой моделью выложил на Hugging Face два русскоязычных набора на знание фактов, WikiWebFacts и HardMultiQA. Для первого отбора этого достаточно. Но ни в одном таком наборе нет формулировок из вашего положения о закупках, внутренних сокращений и номенклатуры, которой не найти в интернете.
Другой тип задачи. Большинство рейтингов проверяет, что модель знает и как рассуждает. В системе поиска по документам от модели требуется другое: прочитать найденные фрагменты, ответить строго по ним и сказать «не нашёл», если ответа там нет. Широкие общие знания здесь иногда даже мешают. На вопрос о сроке согласования модель охотно ответит по общим представлениям о том, как это обычно устроено в компаниях, проигнорировав ваш регламент.
Другой формат документов. Тестовые вопросы рейтингов — чистый текст. Ваш корпус — сканы с распознаванием, таблицы в приложениях, договоры с протоколами разногласий, регламенты в нескольких редакциях. Качество ответа на таком материале зависит от поиска и разбора файлов не меньше, чем от модели. Поэтому тестировать имеет смысл только на том корпусе, с которым система будет работать. Как оценить его состояние заранее, описано в методике оценки архива перед RAG-проектом.
Разница между лидерами рейтинга часто измеряется единицами баллов. На вашей задаче эти модели вполне могут поменяться местами. Поэтому сравнивать нейросети имеет смысл на своём корпусе: лучшая модель для RAG на русском у банка и у машиностроительного холдинга может оказаться разной.
Отсев до теста
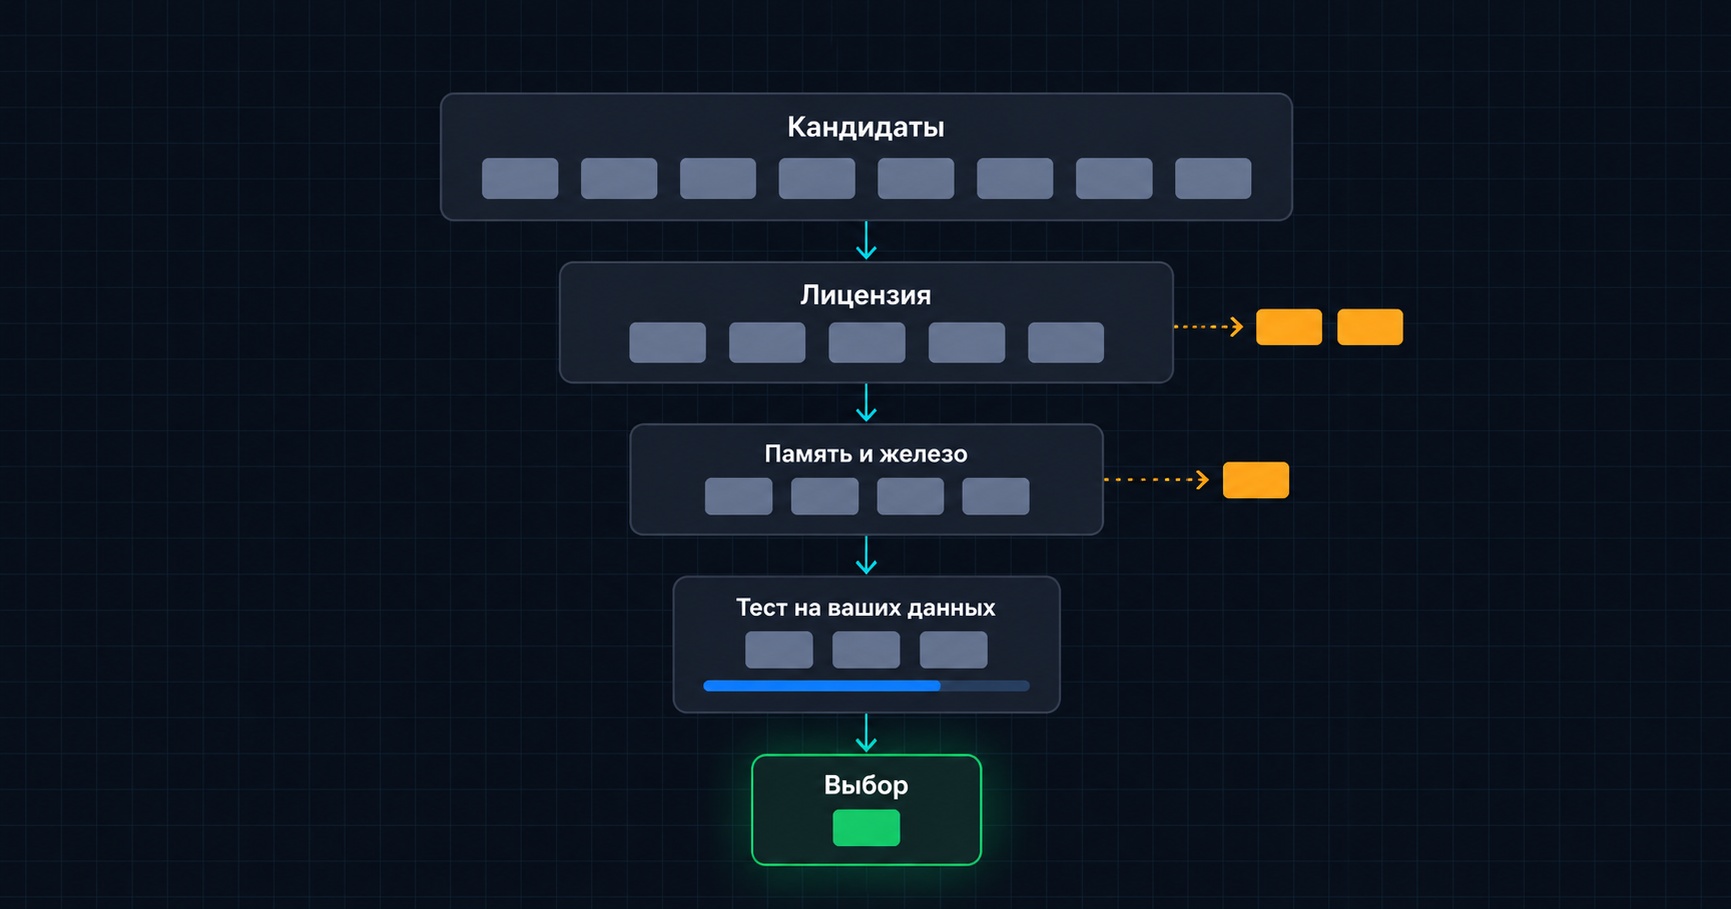
Тестировать стоит только тех, кого вы сможете внедрить. Фильтры дешёвые, на них уходит около половины дня.
Лицензия и статус
Первым делом читают лицензию весов, причём для конкретной версии: внутри одного семейства условия бывают разными. GigaChat 3.5 Ultra и модели DeepSeek V4 распространяются под MIT. У Qwen картина неоднородная: в актуальном поколении 3.8 компактная Qwen3.8-27B выложена под Apache 2.0, а флагман с открытыми весами — под собственной лицензией Alibaba с коммерческими условиями для крупных пользователей. Qwen 4 анонсирована в сентябре, но весов на дату материала нет: если она выйдет посреди вашего теста, её разумнее прогнать по готовому набору позже, чем перекраивать список кандидатов на ходу. Llama идёт под лицензией Meta, которая открытой в строгом смысле не считается.
У Яндекса в сентябре появилась открытая Alice AI Foundation LLM под Apache 2.0, но это базовая модель без инструктивного дообучения, и в недельный тест в таком виде она не годится. Корпоративные редакции GigaChat и YandexGPT для установки в контуре заказчика существуют, их условия обсуждаются с вендором. Если ваша сфера может попасть под ограничения 243-ФЗ, лицензия становится вопросом соответствия; подробно — в разборе статусов национальной и суверенной модели.
Память и железо
У MoE-моделей в видеопамять ложатся все веса, а число активных параметров определяет только скорость. Считать память по активным — типовая ошибка, после которой флагман «на одну карту» требует целого узла. Одни только веса GigaChat 3.5 Ultra в FP8 занимают около 432 ГБ, и примеры запуска от разработчика рассчитаны на восемь ускорителей. Расчёт по шагам — в статье о видеопамяти для LLM в своём контуре. Если у вас сервер на две карты, флагманы выбывают до теста, и это экономит неделю.
Допустимость в вашем контуре
Для госоргана или значимого объекта КИИ это проверка происхождения ПО и записи в реестре под конкретную редакцию и способ поставки. Три фильтра допустимости разобраны в материале о моделях для КИИ и госсектора. Для коммерческой компании без таких требований фильтр сводится к согласованию с ИБ: где выполняются вычисления, куда пишутся журналы, кто обновляет модель.
После трёх фильтров в списке обычно остаются три-четыре модели. Если больше, сократите: каждая лишняя модель добавляет экспертам часы оценки, а качество решения от этого не растёт.
По состоянию на 26 октября 2026 года.
Три типа задач и что в них мерить
Одна и та же модель может хорошо искать по регламентам и посредственно сравнивать редакции договоров. Поэтому до сбора вопросов нужно решить, какая задача главная: от неё зависит, что считать ошибкой.
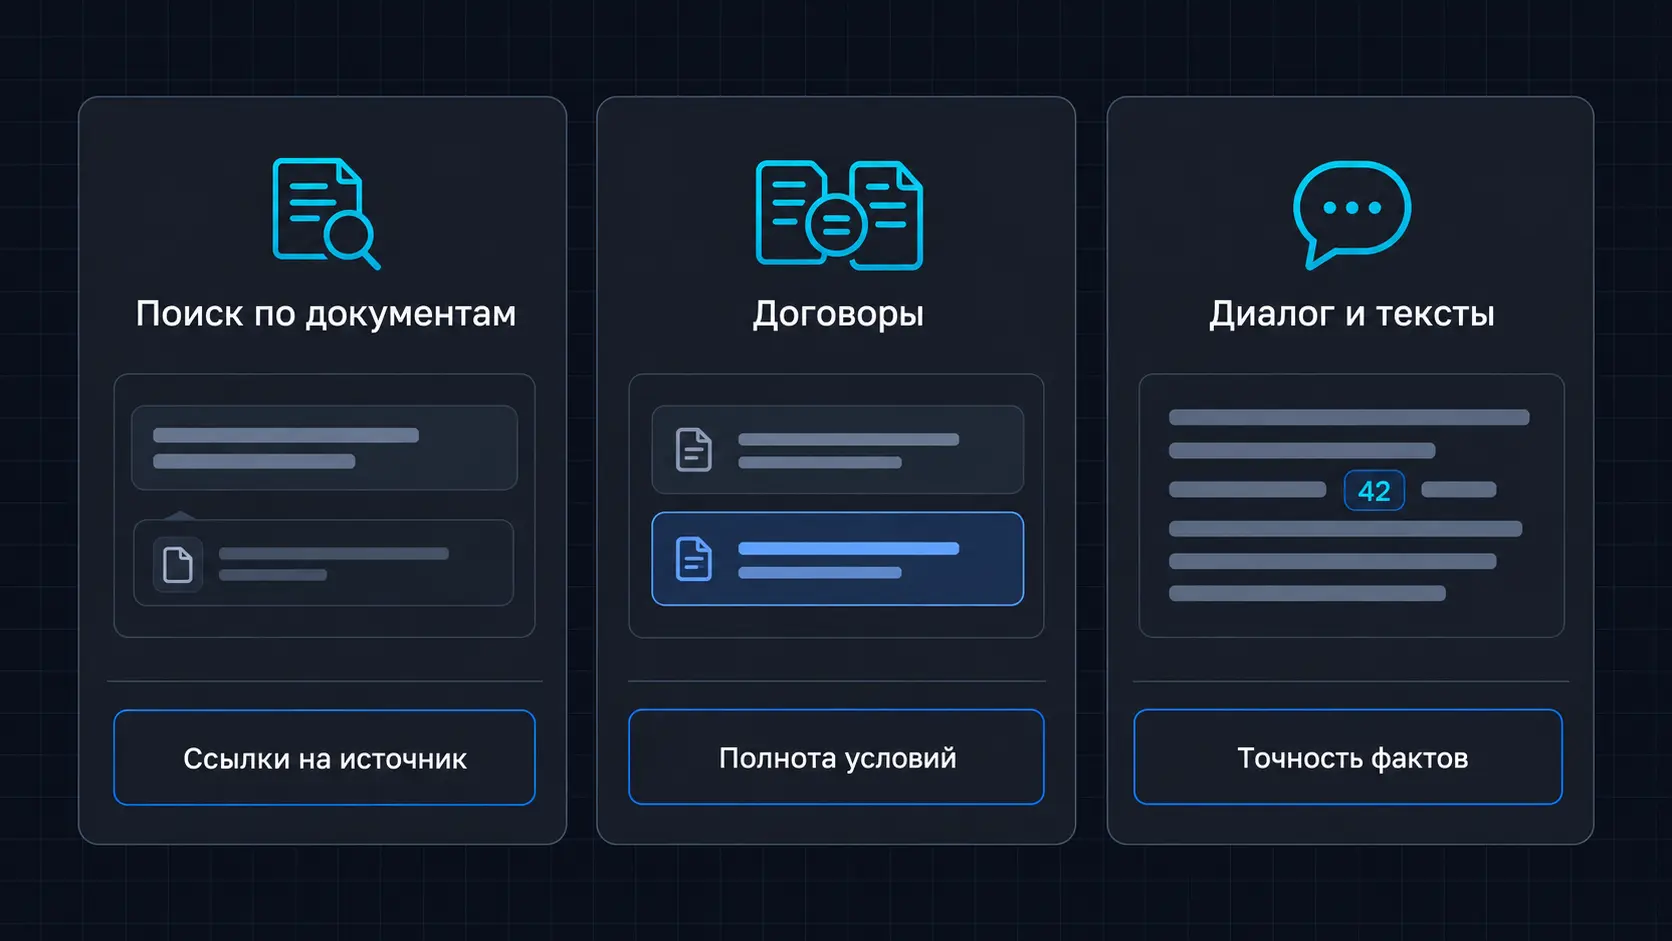
| Задача | Что меряем | Критичная ошибка | Как её ловить |
|---|---|---|---|
| Поиск и ответы по документам | Указан ли верный документ и пункт; доля ответов «в документах этого нет» на вопросы, ответа на которые в корпусе действительно нет | Уверенный ответ со ссылкой на пункт, где этого не написано | Вопросы-ловушки, проверка каждой ссылки по исходнику |
| Работа с договорами | Полнота найденных условий по сравнению с разметкой юриста; доля ложных срабатываний | Пропущенное изменённое условие: санкция, срок, порядок приёмки | Пары редакций договора с заранее известными изменениями |
| Диалог и подготовка текстов | Соблюдение заданного формата и шаблона; фактические ошибки в готовом тексте | Неверная дата, сумма или реквизит в документе, который уйдёт наружу | Сверка каждого факта в черновике с исходными данными |
Приоритеты в этих задачах разные. В договорах полнота важнее точности: пропущенная санкция обходится дороже лишнего срабатывания, которое юрист отбросит за минуту. В поиске по архиву приоритет обратный — честное «не нашёл» ценнее ответа, который каждый раз придётся перепроверять. Как устроен поиск со ссылками на источник и где он обычно ломается, разобрано в статье об RAG-архитектуре.
Если система должна делать и то и другое, тестируйте задачи раздельно, а модель выбирайте по главной. Общий балл по смешанному набору усреднит сильную задачу со слабой, и провал на договорах растворится в хороших ответах по регламентам.
Как собрать тестовый набор за два дня
Откуда брать вопросы
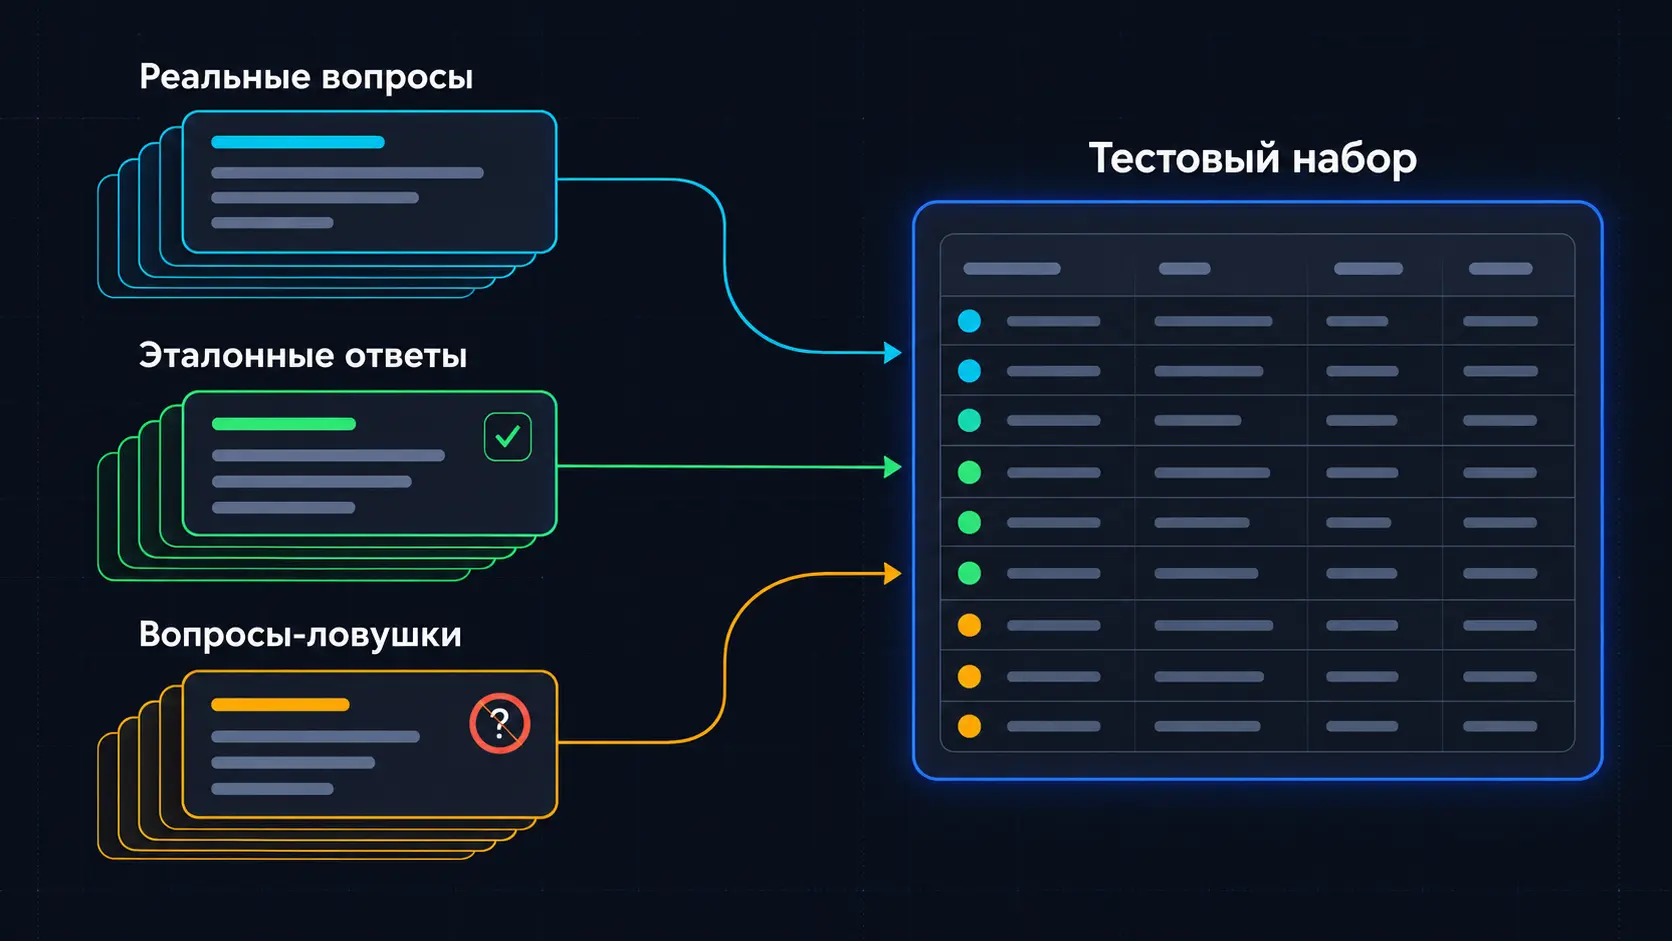
Лучший источник — то, о чём сотрудники уже спрашивают: обращения в поддержку, письма юристам с вопросом «где у нас написано про…», вопросы инженеров по технической документации, переписка в рабочих чатах. Такие вопросы сформулированы неудобно, с опечатками и внутренними сокращениями. Ровно так их и будут задавать системе.
На вопросах, придуманных аналитиком за столом, модели выглядят лучше, чем потом в эксплуатации. Если реальных обращений мало, попросите пятерых будущих пользователей записать по десять вопросов, которые они задавали коллегам за последний месяц. Пропорции держите близкими к реальному потоку: когда две трети обращений касаются кадровых регламентов, набор из одних договорных вопросов ничего не скажет о будущей системе.
Эталонные ответы
Эталон пишут люди, которые завтра будут пользоваться системой: юрист для договорных вопросов, инженер для технических. Красивый текст не нужен. Нужна короткая запись из трёх частей: правильный ответ, документ и пункт, где он содержится, и что в этом вопросе считать грубой ошибкой. Без последней части оценщики разойдутся на первом же спорном ответе.
На этом шаге всплывает неприятное. На часть вопросов эталон написать не получается: в документах противоречие или одновременно действуют две редакции. Такие вопросы из оценки исключают и записывают отдельным списком. Это находка о состоянии архива, и её стоит передать владельцам документов до пилота, иначе модель будут ругать за чужую ошибку.
Вопросы-ловушки
Десять–пятнадцать процентов набора отдают под вопросы, ответа на которые в корпусе нет, но которые похожи на настоящие. Про регламент, которого не существует. Про пункт договора, которого нет в этой редакции. Про оборудование соседнего цеха, документация на которое в корпус не попала. Правильный ответ на ловушку — «в документах этого нет».
На обычных вопросах ответ в корпусе есть, и выдумывать модели незачем, поэтому без ловушек эта склонность проявится только в эксплуатации.
Сколько вопросов
Для одной задачи — от 50 до 100. На таком наборе надёжно видны крупные различия и различия в типе ошибок, а разница в несколько ответов остаётся шумом. Больше сотни не поместится в оценку: при трёх кандидатах и 80 вопросах каждый эксперт читает 240 ответов и в каждом открывает источник. Поэтому в недельном формате удобнее всего три кандидата; если их четыре, отдайте оценке два дня. Если задач несколько, шестьдесят вопросов по главной полезнее, чем по двадцать на каждую из трёх.
Если данные нельзя выносить за контур
Тогда вся процедура проходит внутри. Кандидаты разворачиваются на тестовом стенде в контуре, набор и эталоны хранятся там же, оценщики работают через внутренний интерфейс. Модели с открытыми весами это позволяют без участия разработчика. Корпоративные редакции российских вендоров тестируются только через их поставку в контур, и договориться о ней нужно до начала недели: в среду будет поздно.
Как оценить за три дня
Один стенд для всех
Все кандидаты прогоняются на одном индексе, с одним промптом и одними параметрами генерации. Версию каждой модели, способ квантования и настройки записывают. Через полгода, когда выйдет новая версия и кто-то спросит, почему выбрали эту модель, ответ должен найтись в протоколе: к тому времени половина участников выбора может работать над другими проектами.
Слепая оценка двумя экспертами
Ответы всех моделей на каждый вопрос перемешивают и показывают оценщикам без названий: «ответ А», «ответ Б», «ответ В». Если эксперт видит, где ответила модель, которую он сам предлагал на совещании, оценка смещается — даже у добросовестного человека.
Оценщиков двое, работают они независимо, а расхождения разбирают вместе и записывают. Много расхождений обычно говорит о плохо написанных эталонах, и такие вопросы лучше переписать к следующему прогону.
Шкала из трёх градаций
Отдельно, поверх градации, ставится отметка «критичная ошибка» — по тому определению, которое записано в эталоне. Десятибалльная шкала выглядит точнее, но два эксперта не договорятся, чем «семь» отличается от «восьми», и разброс их оценок съест разницу между моделями.
Скорость на целевом железе
Качество ответа решает не всё. Остаётся вопрос, сколько ждать ответа на том оборудовании, где система будет работать. Меряют два показателя: время до первого слова ответа и время полного ответа при ожидаемой нагрузке, например при 20–30 одновременных запросах. Модель, которая отвечает отлично, но за сорок секунд, в справочной системе для сотрудников не приживётся. В ночной пакетной обработке договоров её скорость может вообще не иметь значения.
Неделя по дням
Стенд с кандидатами должен быть готов к понедельнику. Развёртывание флагманских MoE-моделей в эту неделю не входит: если такой модели ещё нет на вашем оборудовании, время на её установку закладывается отдельно, и иногда оно больше самой недели теста.
Где методика ломается
Тестовые вопросы утекают в настройку. Самая частая ошибка и самая незаметная. Инженер настраивает промпт, подбирает примеры ответов для него и берёт их из тестового набора, потому что они под рукой. Модель, под которую настраивали, выигрывает, и никто не врёт. Правило простое: набор замораживается во вторник, промпт пишется на отдельных вопросах, которых в наборе нет.
Оценивает один человек. Даже опытный эксперт к шестидесятому вопросу устаёт и начинает ставить «частично» там, где утром поставил бы «неверно». Второй оценщик это выравнивает.
Модели запущены по-разному. Одну подняли на сервере заказчика, другую вызвали через API вендора, третью квантовали до четырёх бит на стенде интегратора, потому что иначе не помещалась. Сравниваются уже сборки, а не модели. Если кандидат не помещается на целевое оборудование без агрессивного сжатия, это результат теста сам по себе, и его записывают.
Скорость и память не учитываются. Если лучшая по качеству модель требует вдвое больше ускорителей, чем заложено в бюджете, её результат фиксируют вместе с ценой оборудования. В идеале её стоило отсеять ещё на втором фильтре.
Как читать результат
Последняя типовая ошибка — выбор по среднему баллу. Итоговая таблица соблазняет одной цифрой. Разберём условный пример: поиск по регламентам, 80 вопросов, из них 12 ловушек. Цифры придуманы для иллюстрации метода и не описывают конкретные модели.
| Кандидат | Верно | Частично | Неверно | Выдумал ответ на ловушку | Критичные ошибки |
|---|---|---|---|---|---|
| Модель А | 61 | 9 | 10 | 5 из 12 | 6 |
| Модель Б | 57 | 14 | 9 | 1 из 12 | 1 |
| Модель В | 55 | 15 | 10 | 0 из 12 | 2 |
По числу верных ответов лидирует А: 61 против 57 у Б. Разница — четыре ответа, около пяти процентных пунктов. На выборке из 80 вопросов это в пределах случайного разброса: повторите тест на другой выборке того же размера, и порядок может поменяться.
Пять выдуманных ответов на двенадцать ловушек — проблема другого рода. Каждый такой ответ в эксплуатации — сотрудник, который получил уверенную ссылку на несуществующий пункт и, возможно, принял по ней решение. Разницу в средних объясняет размер выборки, тип ошибок ею не объясняется. Для справочной системы по регламентам это довод против А. Между Б и В разница уже второго порядка: у В нет выдумок на ловушках, но больше частичных ответов, и пользователь чаще будет дочитывать источник сам. Здесь решает эксплуатация — скорость на вашем оборудовании и память. Если разница на ловушках небольшая и вы сомневаетесь, добавьте ещё двадцать–тридцать ловушек и прогоните только их: это полдня работы.
Что считать критичной ошибкой, решает бизнес, и решает до прогона. Для юрслужбы это пропущенная санкция, для инженеров — неверный допуск или ссылка на отменённый документ, для поддержки сотрудников — ответ, который отправляет человека не в тот отдел. Модель с меньшим числом критичных ошибок почти всегда предпочтительнее модели с лучшим средним.
При равенстве по качеству и ошибкам решает эксплуатация: память, скорость, лицензия, люди, которые умеют модель обновлять. Результат недели — кандидат на пилот. Окончательно модель проверяется на реальных пользователях, интеграциях и правах доступа, которых в тесте не было.
Набор после выбора не выбрасывайте. Модели обновляются раз в несколько месяцев, и при каждом обновлении тот же набор прогоняют заново. Тогда переход на новую версию становится регламентной процедурой с понятным критерием «стало лучше или хуже на наших вопросах». Если модель будут закупать, тот же набор задаёт требование к качеству в техзадании — об этом в разборе техзадания на локальную LLM.
Что дальше
Как устроен пилот на ваших данных и что в него входит, описано на странице пилотного проекта.
Частые вопросы
Какая LLM лучше для работы с документами на русском?
Универсального ответа нет. Для закрытого контура обычно рассматривают модели с открытыми весами — GigaChat, DeepSeek, Qwen, — но какая из них лучше справится с вашими документами, зависит от их формата, терминологии и типа задачи. Выбирать стоит тестом на своём корпусе с вопросами-ловушками и слепой оценкой.
Сколько вопросов нужно для теста модели?
Для одной задачи — 50–100 вопросов. На меньшем наборе не видно даже крупных различий между моделями, больший два эксперта не успеют оценить за отведённое время. Десять–пятнадцать процентов набора стоит отдать под вопросы, ответа на которые в документах нет.
Можно ли доверять публичным рейтингам языковых моделей?
Как фильтру первого уровня — да. Русскоязычные наборы вроде MERA измеряют общие навыки модели. Ваших документов, внутренних сокращений и критичных для вас ошибок в них нет, поэтому лидер рейтинга на вашей задаче может оказаться не первым.
Как проверить модель, если данные нельзя выносить за контур?
Развернуть кандидатов на тестовом стенде внутри контура и там же провести прогон и оценку. Модели с открытыми весами это позволяют без участия разработчика, корпоративные редакции российских вендоров — только через их поставку в контур.
Сколько времени занимает выбор языковой модели?
Отсев по лицензии, памяти и допустимости — около половины дня. Сам тест — рабочая неделя: два дня на набор, день на прогон, день на слепую оценку (при четырёх кандидатах — два), день на разбор. Развёртывание стенда в эту неделю не входит: если флагманских моделей на вашем оборудовании ещё нет, это время закладывается отдельно.
Чем тест модели отличается от пилота?
Тест сравнивает модели на замороженном наборе вопросов в одинаковых условиях и отвечает на вопрос, какую модель брать. Пилот проверяет всю систему: реальных пользователей, интеграции, права доступа, нагрузку.
Шаблон тестового набора для выбора LLM
PDF, 12 страниц, и таблица Excel для архитектора, руководителя проекта и двух экспертов. Набор из реальных вопросов с ловушками, слепая оценка, сводная по критичным ошибкам и протокол решения — заготовки на неделю сравнения моделей.
Сравним модели на ваших документах
Если вы хотите проверить, какая модель подойдёт вашей задаче, AZONE-AI проведёт сравнение в вашем контуре: поможем собрать тестовый набор из реальных вопросов, развернём кандидатов на одном стенде и организуем слепую оценку. По результатам — модель-кандидат и архитектура пилота.