Сколько видеопамяти нужно LLM в своём контуре: расчёт для GigaChat 3.5 Ultra и DeepSeek V4
Открытые флагманы этого лета весят сотни гигабайт, а в техзаданиях их нередко считают по активным параметрам. Разбираем методику расчёта видеопамяти для корпоративной нагрузки — два-три десятка одновременных сессий, контекст до 32K — и показываем, что помещается в один сервер, а чему нужен кластер.
Коротко
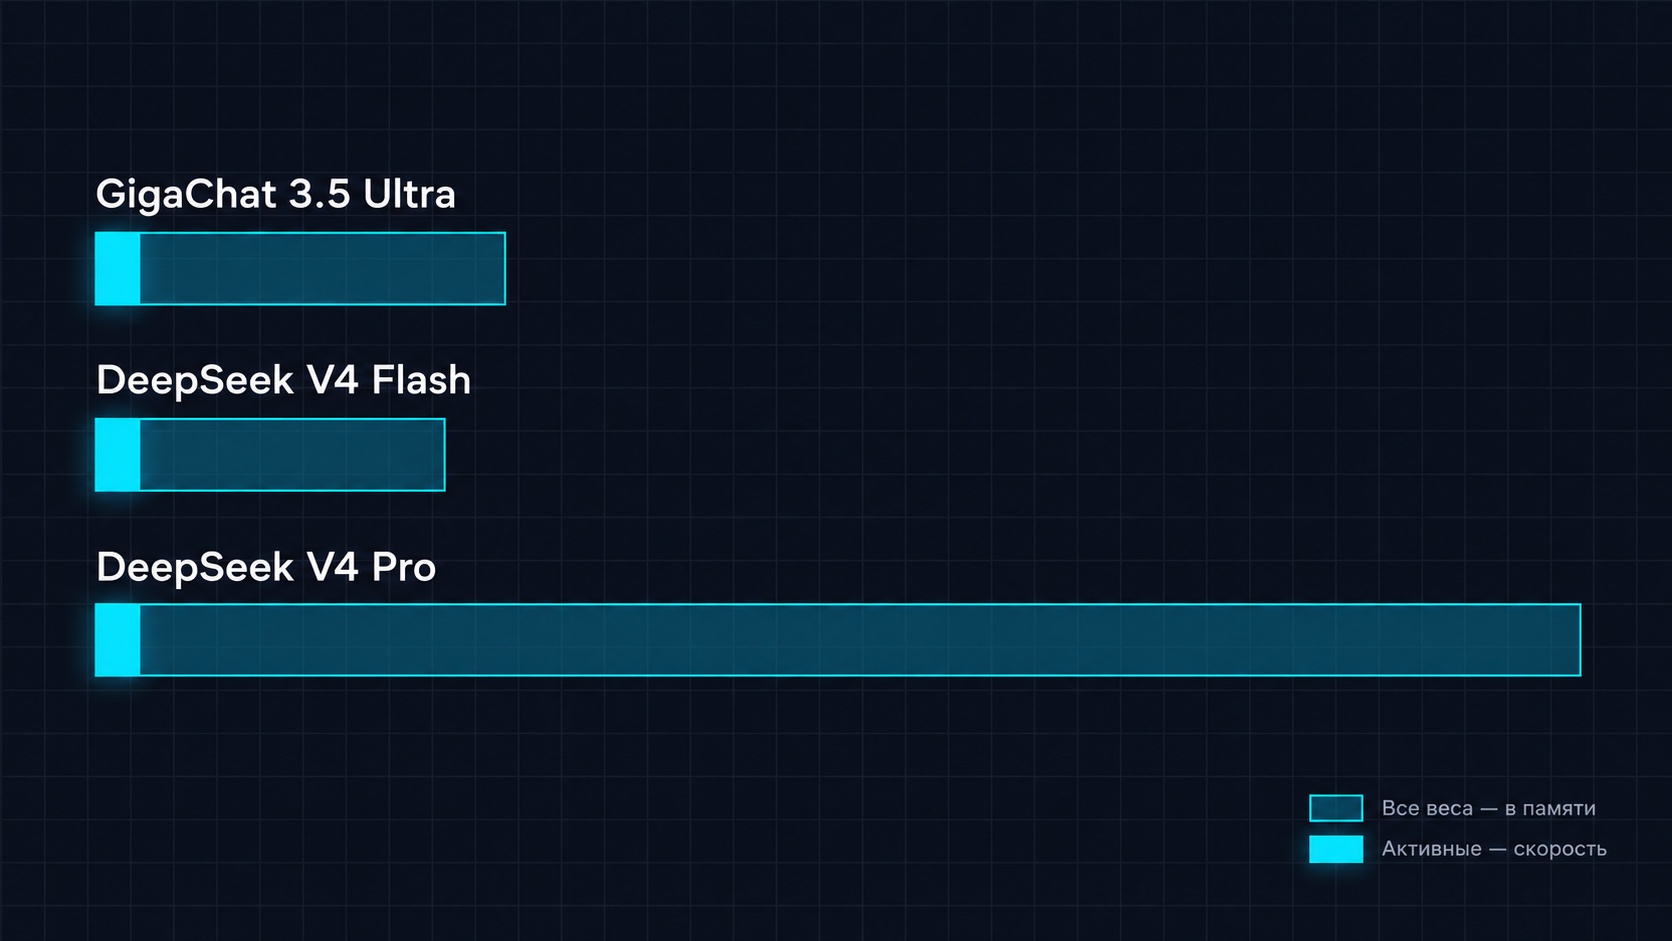
Открытые флагманы этого лета — сотни миллиардов параметров: у GigaChat 3.5 Ultra их 432 млрд, у DeepSeek V4 Pro — 1,6 трлн. Под такую модель нужен узел на восемь ускорителей или кластер. Модель среднего класса на 20–40 млрд параметров помещается в один сервер с одной-двумя картами.
Типовая ошибка в техзаданиях этого года — считать память по активным параметрам. В MoE-модели на каждый токен работает малая часть весов, но лежать в памяти ускорителей должны все.
Главное: память определяют все веса модели и их формат, скорость — активные параметры. Расчёт укладывается в одну строку, но формат весов, архитектура внимания и длина документов сдвигают результат на целый класс конфигурации.
Сцена из техзаданий этого года. Модель выбрана — GigaChat 3.5 Ultra, в обосновании стоит «28 млрд активных параметров», в спецификации оборудования — сервер с двумя картами по 80 ГБ. Кто-то умножил 28 млрд на 2 байта, получил 56 ГБ и добавил запас. Арифметика верная, посчитана не та величина: на двух таких картах эта модель не поместится даже в 4 битах.
Путаница понятна. MoE-модели описывают двумя числами, и в анонсах громче звучит второе — оно объясняет, почему модель быстрая. Публичные расчёты в сети тоже не выручают: обычно они сделаны под одну видеокарту энтузиаста, один запрос за раз и агрессивное квантование. Корпоративная нагрузка — это два-три десятка человек одновременно и длинные документы в контексте.
Материал для архитекторов и ИТ-директоров, которые пишут техзадание на GPU-инфраструктуру под LLM в своём контуре. Какую модель выбрать под задачу, разобрано в сравнении отечественных LLM. Здесь следующий шаг: сколько памяти ей нужно, как это посчитать и где типовая методика ошибается.
Что открылось летом
Летом до финальных версий дошли две открытые линейки флагманского класса. Данные ниже — по состоянию на 23 сентября 2026 года.
GigaChat 3.5 Ultra Сбер выложил 6 июля под лицензией MIT на Hugging Face и GitVerse. Это MoE-модель на 432 млрд параметров, из которых на каждый токен работают 28 млрд. Родной формат — FP8: модель в нём обучалась, и в нём же разработчики рекомендуют её запускать. Рядом опубликованы версия в BF16, GGUF-сборки и базовый чекпоинт для дообучения.
DeepSeek V4 вышла весной в предварительной версии; финальные веса Flash опубликованы 31 июля, Pro — 13 августа. Обе модели под MIT, обе с контекстом до 1 млн токенов. У Flash 284 млрд параметров при 13 млрд активных, у Pro — 1,6 трлн при 49 млрд. Формат весов у рабочих версий смешанный: эксперты хранятся в FP4, остальное — в FP8.
10 сентября DeepSeek выпустила V4.1 Flash — с новой архитектурой и обработкой изображений. В таблицу она не вошла: практика её развёртывания только складывается, а параметры у неё учитываются иначе, чем у V4, — часть из них, по сторонним разборам, может храниться вне памяти ускорителя.
Для статуса модели в терминах 243-ФЗ одной лицензии MIT мало; как устроены статусы суверенной и национальной модели, мы разбирали отдельно. Сравнение с коммерческими моделями — в материале об open-source и коммерческих LLM.
Методика: веса, разрядность, запас
Число параметров умножается на объём одного параметра в выбранном формате: BF16 — 2 байта, FP8 — 1 байт, 4 бита — около 0,5 байта плюс небольшие накладные расходы на масштабные коэффициенты. Получается объём весов. К нему добавляется запас около 1,4× под KV-кэш, буферы движка и промежуточные вычисления. Множитель рассчитан на типовой корпоративный профиль: 20–30 одновременных сессий с окном до 32K токенов, при котором длинные документы одновременно держат лишь немногие. Где такой расчёт перестаёт работать, разберём ниже.
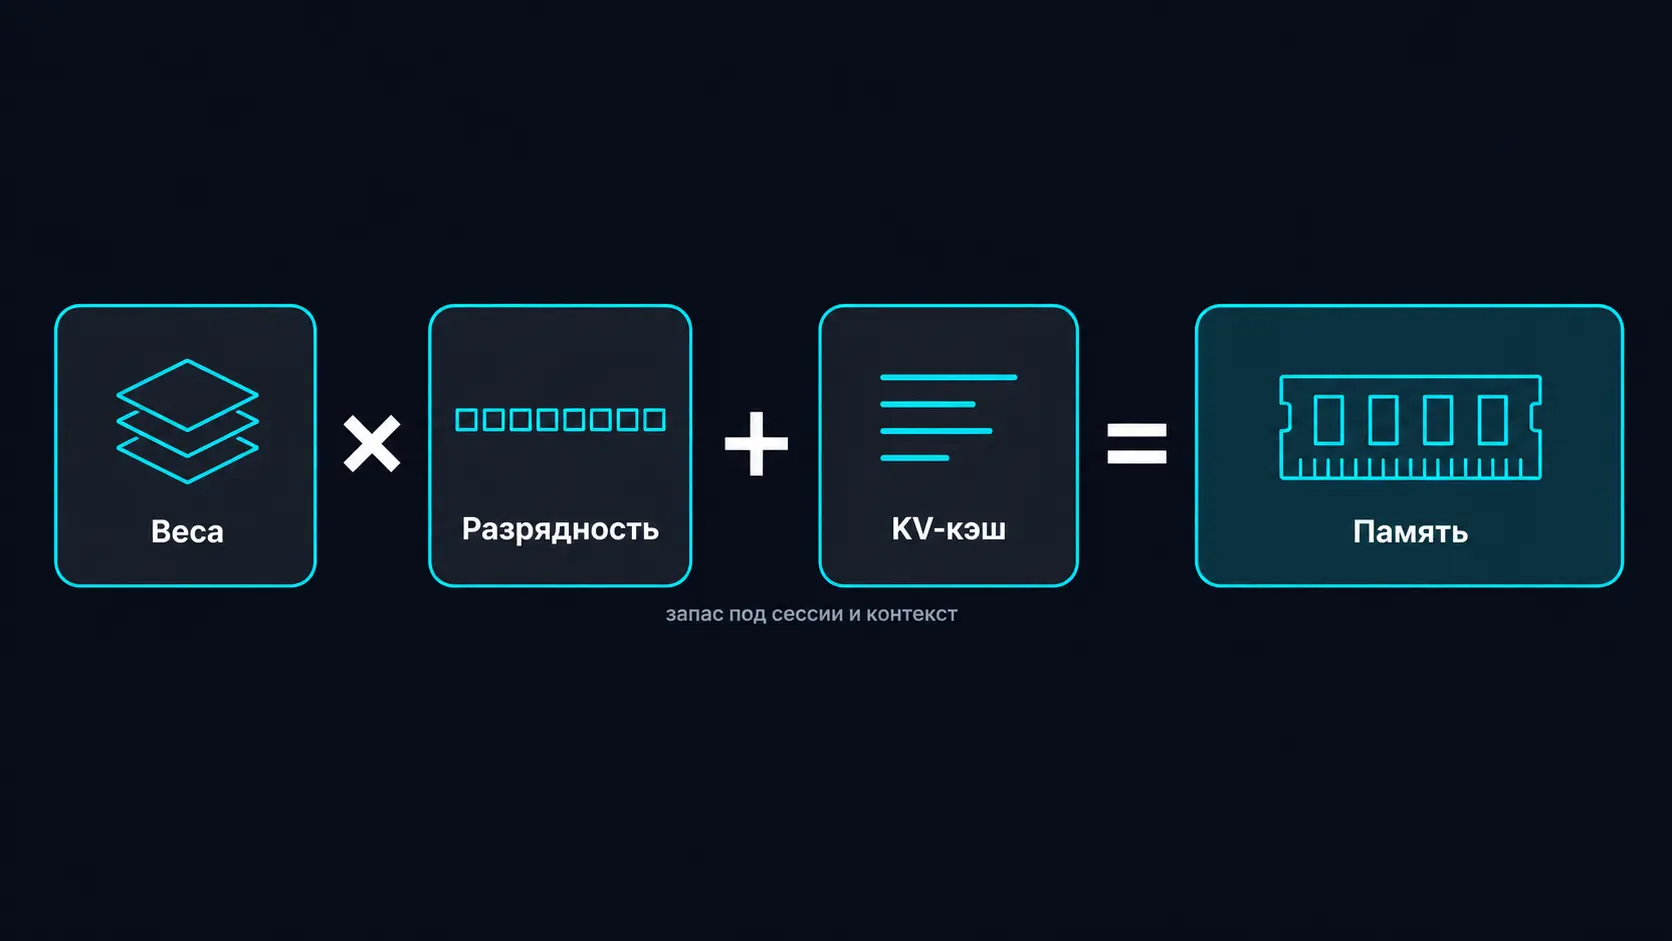
KV-кэш — память, где модель держит представления уже прочитанного текста каждой сессии. Он растёт с длиной контекста и числом пользователей и при корпоративной нагрузке становится второй статьёй расхода после весов.
Пример по шагам: GigaChat 3.5 Ultra в FP8
Последний шаг объясняет, почему восемь карт по 80 ГБ — вариант рабочий, но впритык. У GigaChat 3.5 Ultra компактный KV-кэш, и 80 ГБ на него хватает при умеренной нагрузке. Если пользователей станет вдвое больше или в контекст пойдут длинные документы, узел упрётся в память раньше, чем в вычисления. Восемь карт по 141 ГБ дают тот же класс конфигурации, но оставляют около 500 ГБ сверх расчётного ориентира.
Та же модель в BF16 весит около 864 ГБ, с запасом — около 1,2 ТБ. Это больше, чем есть у восьми карт по 141 ГБ, то есть уже несколько узлов. Для работы разработчики BF16 и не предлагают: в карточке этой версии прямо рекомендовано запускать FP8.
MoE: память и скорость — разные величины
В MoE-модели каждый слой содержит набор экспертов — независимых блоков, из которых маршрутизатор для каждого токена выбирает несколько. Отсюда два числа в описании: сколько параметров у модели всего и сколько работает на одном токене.
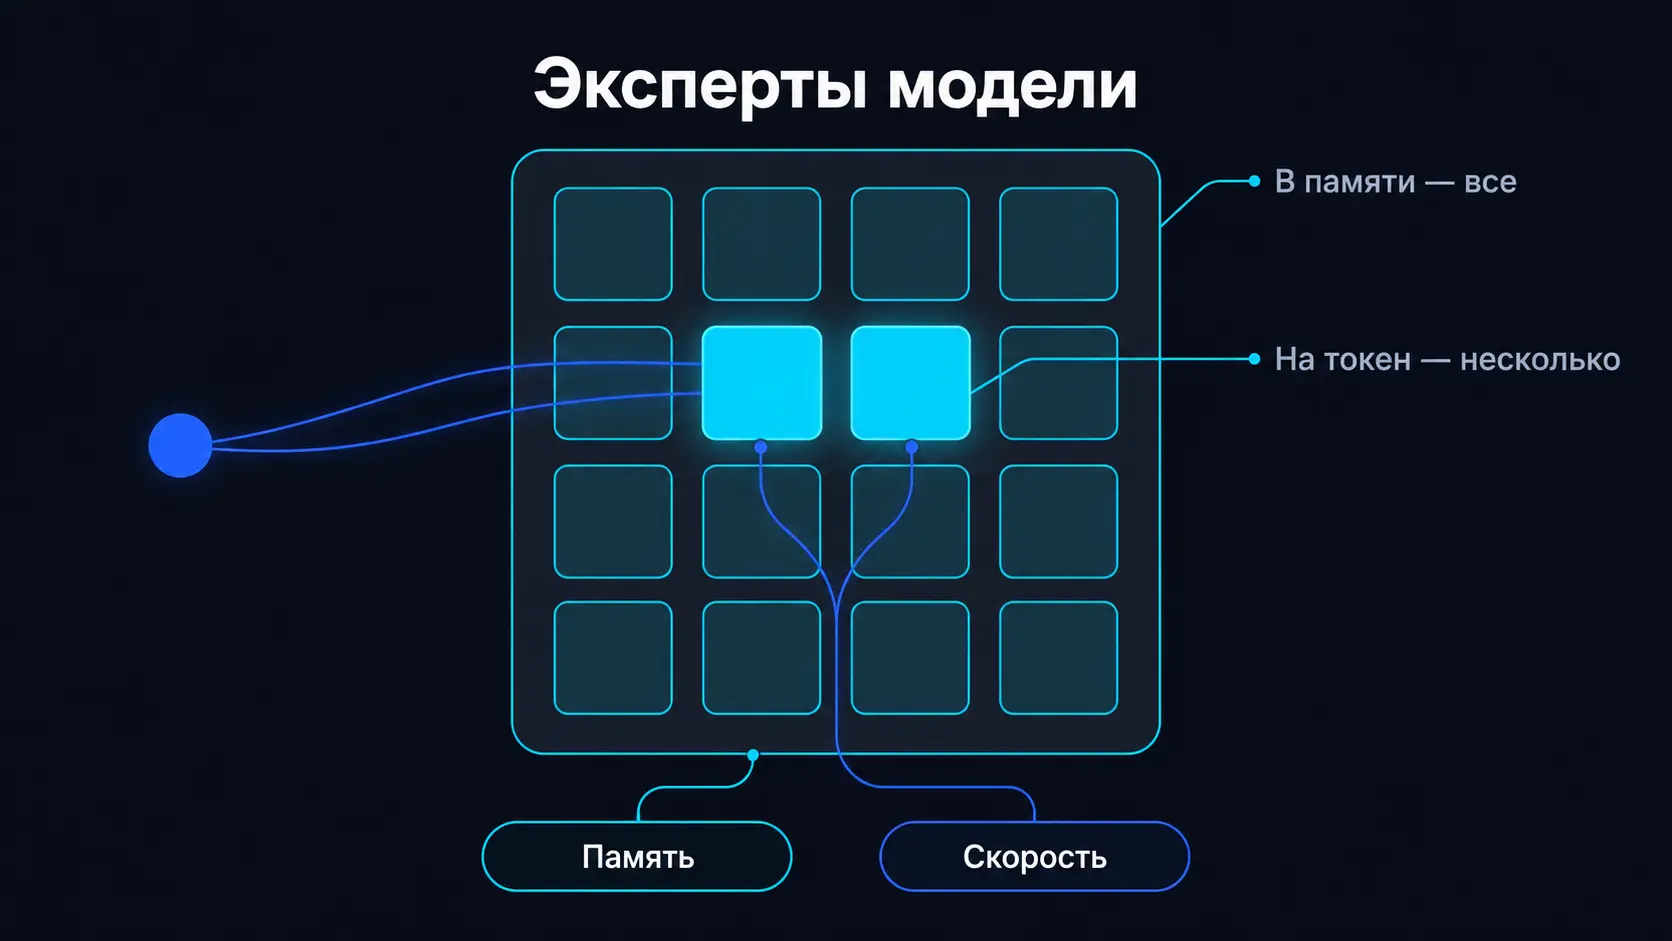
Для памяти важно первое число. Маршрутизатор выбирает экспертов заново на каждом слое для каждого токена, и заранее неизвестно, какие понадобятся. Когда одновременно идут два десятка сессий с разными документами, за один шаг генерации задействуется почти весь набор. Держать в памяти ускорителей только «популярных» экспертов не получится: промах означает подгрузку весов из оперативной памяти сервера, и скорость падает в разы. Выгрузку экспертов в оперативную память ряд движков умеет, и для лабораторного стенда с одним пользователем это рабочий вариант. Для корпоративной нагрузки — нет.
Активные параметры важны для другого. На каждом шаге генерации движок читает только веса выбранных экспертов, поэтому скорость выдачи токенов у GigaChat 3.5 Ultra по порядку величины ближе к плотной модели на 30 млрд параметров, чем к плотной на 400 млрд, — при условии, что все веса уже лежат в памяти ускорителей. Активные параметры определяют и нагрузку на вычислители: сколько запросов узел обработает при заданной задержке ответа.
У этой экономии есть оборотная сторона, о которой в техзаданиях вспоминают реже. При экспертном параллелизме эксперты распределяются по картам, и на каждом слое токены пересылаются между ними. Внутри узла это идёт по быстрой шине между ускорителями, между узлами — по сети. Поэтому переход от узла к кластеру означает больше, чем дополнительные карты: межузловая сеть с высокой пропускной способностью, InfiniBand или RoCE, становится частью требований, и без неё выигрыш от MoE съедается пересылками.
Ориентиры по моделям
Цифры ниже — арифметика по методике выше, без учёта конкретного движка. Это ориентир для первого разговора о бюджете, спецификацию из него собирать рано.
| Модель | Всего / активных | Веса в FP8 | Веса в BF16 | Опубликованные веса | Ориентир с запасом | Класс конфигурации |
|---|---|---|---|---|---|---|
| GigaChat 3.5 Ultra | 432 млрд / 28 млрд | ≈ 432 ГБ | ≈ 864 ГБ | FP8 (родной), BF16, GGUF | ≈ 605 ГБ (FP8) | Узел на 8 ускорителей; в BF16 — кластер |
| DeepSeek V4 Flash | 284 млрд / 13 млрд | ≈ 284 ГБ | ≈ 568 ГБ | Эксперты FP4, остальное FP8; ≈ 160 ГБ | ≈ 225 ГБ (родной формат) | Один сервер на 2–4 ускорителя |
| DeepSeek V4 Pro | 1,6 трлн / 49 млрд | ≈ 1,6 ТБ | ≈ 3,2 ТБ | Эксперты FP4, остальное FP8; ≈ 0,87–0,9 ТБ | ≈ 1,2–1,25 ТБ (родной формат) | Кластер; узел 8 × 141 ГБ — на пределе |
| Плотная модель 20–40B (например, Qwen3.8-27B) | 20–40 млрд, активны все | ≈ 20–40 ГБ | ≈ 40–80 ГБ | BF16, FP8, квантованные сборки | ≈ 28–56 ГБ (FP8), ≈ 56–112 ГБ (BF16) | Один сервер, 1–2 ускорителя* |
Ориентировочно, по состоянию на 23 сентября 2026 года; ГБ и ТБ десятичные. Класс конфигурации — для ускорителей H100 (80 ГБ), RTX PRO 6000 Blackwell (96 ГБ) и H200 (141 ГБ). Объём весов DeepSeek V4 — по размеру файлов чекпоинтов, округлённо. * Для плотных моделей на длинных документах KV-кэш считается отдельно — см. раздел о поправке на архитектуру внимания.
У DeepSeek V4 столбцы FP8 и BF16 во многом теоретические. Рабочие веса выпущены в смешанном формате, и Flash в нём занимает около 160 ГБ — меньше, чем занял бы чистый FP8. Аппаратная поддержка FP4 есть у поколения Blackwell, у Hopper (H100, H200) её нет: там эксперты обрабатываются через преобразование на лету или используется полностью FP8-сборка, которая почти вдвое тяжелее. Какой режим поддерживает выбранная версия движка на выбранной карте, проверяется до закупки.
У моделей среднего класса все параметры активны: 27 млрд — это и память, и скорость. Qwen3.8-27B, актуальная плотная модель этого размера у Qwen (лицензия Apache 2.0, выпущена в августе), в FP8 с запасом укладывается в одну карту на 80 ГБ. Но именно для плотных моделей множитель 1,4× требует проверки — об этом в следующем разделе.
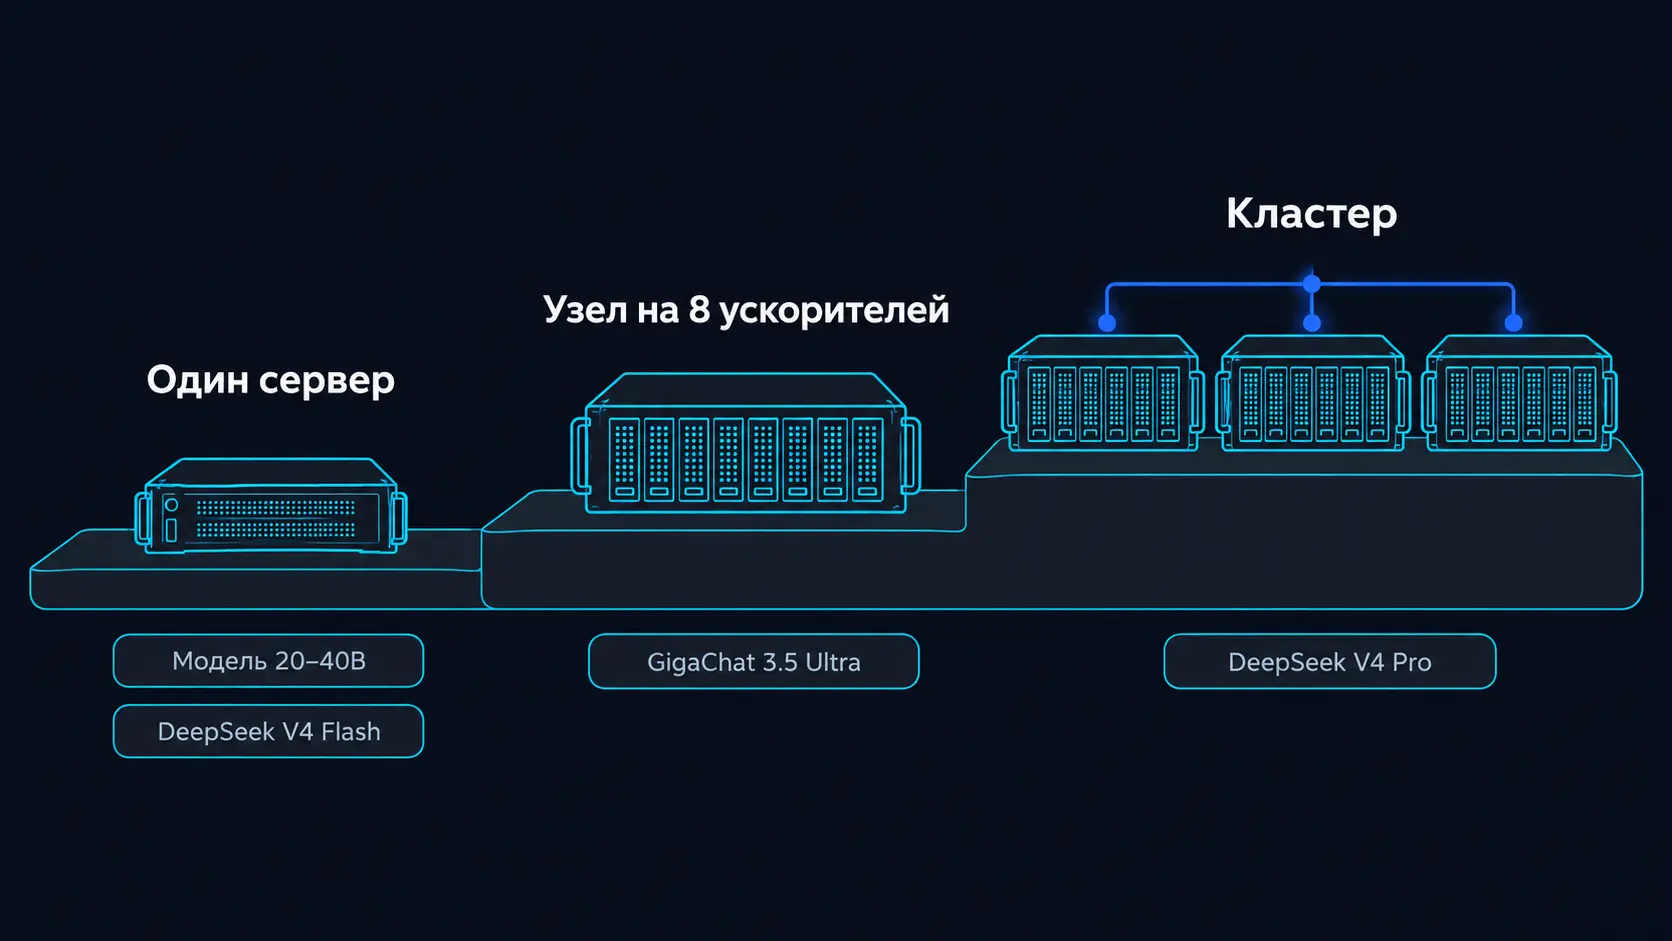
Схема построена для FP8 или родного формата весов и карт на 141 ГБ. На картах по 80 ГБ ступени сдвигаются: DeepSeek V4 Flash в родном формате требует уже четырёх ускорителей, а у GigaChat 3.5 Ultra пропадает запас на рост нагрузки.
Поправка на архитектуру внимания
Множитель 1,4× — усреднение, и его точность зависит от того, сколько памяти модель тратит на каждый токен контекста. У новых флагманов KV-кэш устроен иначе, чем у классических плотных моделей, и это уточняет расчёт в обе стороны.
Где запас получается с избытком
GigaChat 3.5 Ultra использует гибридное внимание: часть слоёв построена на MLA, остальные — на линейном внимании GatedDeltaNet, чьё состояние не растёт с длиной контекста. По данным разработчиков, KV-кэша на токен модели нужно примерно вчетверо меньше, чем предыдущему флагману GigaChat 3.1; абсолютного значения в карточке нет. DeepSeek V4 сжимает KV-кэш по длине последовательности — в 4 или в 128 раз в зависимости от слоя — и хранит его в FP8. На контексте 1 млн токенов Pro расходует около 10% KV-кэша DeepSeek V3.2, Flash — около 7%.
На профиле «32K × 25 сессий» KV-кэш этих моделей занимает малую долю от объёма весов, и множитель 1,4× даёт запас сверху. Этим объясняется, почему NVIDIA публикует рецепты развёртывания DeepSeek V4 Pro на одном узле из восьми H200, хотя по методике получается около 1,2 ТБ при 1128 ГБ в узле. Цена такой компоновки видна в самих рецептах: в одном из них для FP8-версии на восьми H200 контекст ограничивали примерно 86 тыс. токенов — памяти на большее не хватало. Срезать запас до нуля всё равно не стоит: память нужна движку под буферы, графы вычислений и модули спекулятивного декодирования, которые есть у обеих моделей.
Где запаса может не хватить
Обратная ситуация — плотные модели с классическим вниманием на длинных документах. Объём KV-кэша на токен считается так: 2 × число слоёв × число KV-голов × размерность головы × байт на значение. Все четыре величины есть в config.json модели.
Возьмём условную плотную модель на 32 млрд параметров с типовой для этого класса конфигурацией: 64 слоя, 8 KV-голов, размерность головы 128, KV-кэш в BF16. Получается 256 КБ на токен. 25 сессий по 32K токенов — это около 820 тыс. токенов одновременно, или около 215 ГБ KV-кэша при 64 ГБ весов. Множитель 1,4× закладывает на KV-кэш около 26 ГБ, то есть примерно 100 тыс. токенов на всех — в среднем по 4K на сессию.
Для чата и RAG с короткими фрагментами такого среднего хватает: сессии редко заполняют контекст одновременно. Если сценарий — сравнение договоров целиком или разбор длинных отчётов, KV-кэш считают отдельно, и он может оказаться больше самих весов. Хранение KV-кэша в FP8 уменьшает эту цифру вдвое, но вопроса не снимает. У современных моделей среднего класса внимание бывает гибридным, поэтому для конкретной модели значения берутся из её config.json.
Какая модель уместна для какого контура
Флагман оправдан там, где качество ответа на сложной задаче важнее стоимости. Чаще всего это агентные сценарии, в которых модель несколько шагов подряд планирует и вызывает инструменты, и работа с кодом. И там, где есть бюджет на узел с восемью ускорителями или кластер, а также люди, которые будут его эксплуатировать.
В закрытом контуре к этому добавляется логистика. Веса — 432 ГБ у GigaChat 3.5 Ultra, около 0,9 ТБ у DeepSeek V4 Pro — заносят внутрь на согласованном носителе и сверяют по контрольным суммам. Локальное зеркало держат на случай переустановки. На момент выхода GigaChat 3.5 Ultra примеры запуска в карточке требовали сборки vLLM и SGLang из веток с доработками. В контуре без интернета такие сборки готовят заранее и фиксируют их версии — иначе обновление движка превращается в отдельный проект.
Для большинства корпоративных сценариев RAG и работы с документами достаточно модели среднего класса. Качество ответа там определяется прежде всего поиском и состоянием архива: если нужный документ не нашёлся или нашлась устаревшая версия, флагман ответит так же неверно. Как оценить архив до старта проекта, мы разбирали в материале о подготовке к RAG. Последовательность, которую мы рекомендуем: пилот на модели среднего класса, затем сравнение с флагманом на одних и тех же вопросах из реальной работы. Если пользователи разницы не видят, кластер не нужен.
Ошибиться можно и в обратную сторону. Платформа «на вырост», выбранная под перспективную задачу, через полгода оказывается загружена на малую долю мощности, потому что задача так и не вышла из стадии обсуждения. А у узла на восемь ускорителей есть требование, которого нет в расчёте видеопамяти: сценарий, который мы уже описывали, — узел подобран и прошёл по реестру, а на этапе размещения выясняется, что в серверной нет стойки под такую плотность по питанию и теплу, и монтаж откладывается на квартал.
Конфигурации AI-Контура ложатся на ту же лестницу. Контуры S и M рассчитаны на модели 13–34 млрд параметров, то есть на средний класс из таблицы. S — один GPU-узел для рабочей группы до 20 человек. M — до 100 пользователей, дообучение модели и кластер, который здесь нужен ради резервирования: по памяти модель среднего класса укладывается в один узел. Контур L рассчитан на модели от 70 млрд параметров или несколько моделей на отказоустойчивом кластере для 100 пользователей и более. Флагманские MoE вроде GigaChat 3.5 Ultra и DeepSeek V4 тоже относятся к L, но считаются с повышающим коэффициентом: узел на восемь ускорителей H-класса, да ещё с резервированием, заметно дороже типовой конфигурации. Во что обходится такой контур целиком, с работами и эксплуатацией, — в разборе бюджета on-premise LLM.
Ускорители, доступные в России
Расчёт выше опирается на ускорители с памятью 80, 96 и 141 ГБ. Для расчёта у карты важны две характеристики: объём памяти и наличие быстрой связи между картами внутри узла. Что из этого реально поставляется в Россию, мы разбирали в материале об импортозамещении ИИ-инфраструктуры. Методика от производителя не зависит: меняется только делитель в третьем шаге и поддержка FP8 и FP4 в движке.
Итоги
Память определяется всеми параметрами модели, скорость — активными. В техзадании это две разные строки, и бюджет на оборудование задаёт первая.
По DeepSeek V4 Pro решение зависит от профиля нагрузки. Если рабочие сессии укладываются в десятки тысяч токенов, а пользователей немного, один узел из восьми карт по 141 ГБ — рабочий вариант. Если в контекст идут длинные документы или нагрузка будет расти, закладывать нужно кластер.
Формат весов сдвигает результат сильнее, чем кажется по анонсам. Родной формат модели и поддержку FP4 на выбранных ускорителях проверяют до закупки.
Множитель 1,4× годится как стартовая оценка. Для моделей со сжатым или линейным вниманием он избыточен, для плотных моделей на длинных документах KV-кэш считают отдельно по конфигурации модели.
Что дальше
Порядок действий, который экономит время на согласовании спецификации.
Частые вопросы
Сколько видеопамяти нужно GigaChat 3.5 Ultra?
Веса в родном формате FP8 занимают около 432 ГБ, с запасом под KV-кэш и служебную память движка ориентир — около 605 ГБ. Это узел на восемь ускорителей: восемь карт по 80 ГБ работают впритык, восемь по 141 ГБ оставляют запас под рост нагрузки и длинный контекст. Версия в BF16 вдвое тяжелее и уходит в несколько узлов.
Почему MoE-модель занимает столько памяти, если активно мало параметров?
Маршрутизатор выбирает экспертов заново для каждого токена на каждом слое, и при двух десятках одновременных сессий за один шаг генерации задействуется почти весь их набор. Поэтому в памяти ускорителей должны лежать все веса модели. Активные параметры определяют скорость генерации и нагрузку на вычислители, но не объём памяти.
Хватит ли одного сервера на 8 GPU для открытого флагмана?
Для GigaChat 3.5 Ultra в FP8 — да, для DeepSeek V4 Flash хватит и четырёх карт. DeepSeek V4 Pro в родном формате занимает около 0,9 ТБ: на восьми картах по 141 ГБ он запускается, но с ограничениями по длине контекста и нагрузке, а для длинных документов и роста числа пользователей закладывают кластер. Ответ зависит от объёма памяти одной карты, поэтому считать нужно под конкретный ускоритель.
FP8 или BF16 — что выбрать для запуска LLM?
Для работы разумно брать формат, в котором модель выпущена: у GigaChat 3.5 Ultra это FP8, у DeepSeek V4 — FP4 для экспертов и FP8 для остальных весов. BF16 вдвое тяжелее FP8 и нужен в основном для дообучения и собственного квантования. Для моделей среднего класса потери от FP8 обычно невелики, но проверять их стоит на своих задачах.
Можно ли запустить флагманскую модель в 4 битах?
Можно: для GigaChat 3.5 Ultra разработчики выложили GGUF-сборки, в том числе 4-битные, для DeepSeek V4 такие сборки делает сообщество. У GigaChat 3.5 Ultra память сокращается примерно вдвое относительно FP8; у DeepSeek V4 выигрыш заметно меньше, потому что эксперты в родном формате уже хранятся в FP4. Качество при этом снижается, а движки для таких сборок обычно рассчитаны на меньшее число одновременных пользователей. Для пилота вариант рабочий, для промышленной эксплуатации — только после сравнения на своих данных.
Сколько видеокарт нужно, чтобы запустить DeepSeek V4 Flash локально?
Хватит одного сервера. В родном формате веса занимают около 160 ГБ, с запасом — около 225 ГБ, и официальные примеры запуска рассчитаны на четыре ускорителя. На картах поколения Hopper, где нет аппаратной поддержки FP4, эксперты обрабатываются через преобразование на лету, и поддержку такого режима стоит проверить на целевой версии движка до закупки.
Сравнительная таблица: LLM для on-premise 2026
PDF, 10 страниц для CTO, архитекторов и ИБ. 12 позиций в таблице моделей, расчёт видеопамяти, критерии выбора, конфигурации железа и чек-лист перед пилотом. Редакция 09.2026.
Рассчитаем конфигурацию под вашу модель и нагрузку
Таблица из статьи — отправная точка. AZONE-AI проводит экспресс-оценку: сценарии, пиковая нагрузка, длина документов в контексте, требования к среде исполнения. По результатам — конфигурация под выбранную модель и архитектура пилота в вашем контуре, при необходимости — в аттестованной среде.