Как оценить корпоративный архив перед RAG-проектом
Разговор о RAG почти всегда начинается с модели и почти всегда должен начинаться с архива. Методика оценки корпуса, которую мы прогоняем перед пилотом: что считать, как замерить текущую скорость поиска и по каким признакам видно, что корпус к индексации ещё не готов.
Коротко
Ниже — методика оценки корпуса, которую мы прогоняем перед пилотом: что считать, как замерить текущую скорость поиска, какие метрики собираются только заранее и по каким признакам видно, что корпус к индексации ещё не готов.
Наблюдения собраны на пяти внедрениях в производстве и промышленных холдингах. Оценка снимает большую часть вопросов о сроках и деньгах до того, как они дойдут до защиты проекта.
Главное: качество RAG-поиска определяется состоянием корпуса, а не выбором модели. На всех пяти внедрениях основные доработки пришлись на загрузку, метаданные и версионность.
Материал для ИТ-директоров и владельцев документооборота, которые оценивают RAG в план следующего года, и для руководителей ИБ, которым такой проект согласовывать.
Заказчиков мы не называем: проекты закрыты соглашениями о конфиденциальности, часть — в контуре с коммерческой тайной. Отдельный кейс с деталями по одному внедрению опубликован: семантический поиск по архиву в промышленном холдинге.
Что оценка отвечает и чего не отвечает
Оценка корпуса отвечает на четыре вопроса: сколько документов реально дойдёт до индекса, какая часть из них будет пригодна для поиска, сколько времени займёт подготовка и во что упрётся разграничение доступа. Этого достаточно, чтобы назвать реалистичный срок пилота и понять, какой сценарий брать первым.
Чего оценка не даёт — качества выдачи. Релевантность измеряется только на работающей системе, никакой аудит корпуса её не предскажет. Не даёт она и ответа на вопрос, будут ли люди пользоваться результатом: это выясняется на третьем месяце эксплуатации, когда заканчивается эффект новизны и внимание руководства.
Во всех пяти проектах на входе нам говорили, что документы в порядке. Ни в одном архив не оказался единым хранилищем с внятными метаданными. Это не упрёк заказчикам: люди оценивают архив по той его части, с которой работают сами, а она обычно самая свежая и самая аккуратная.
Инвентаризация: что считать
| Параметр | Как измерить | Почему важен |
|---|---|---|
| Общий объём | Число файлов и суммарный размер по каждому источнику | Определяет время первичной индексации |
| Доля сканов | Выборка 200–300 файлов, проверка наличия текстового слоя | Главный фактор разброса сроков между проектами |
| Качество текстового слоя | Ручная проверка выборки сканов: печати, рукописные пометки, перекос | Определяет, нужен ли отдельный этап распознавания |
| Глубина дублирования | Хеши содержимого по нормализованному тексту | Показывает, сколько версий одного документа лежит рядом |
| Наличие метаданных | Доля документов с датой, автором, подразделением, типом | Без них не работает ни фильтрация по правам, ни отсечение устаревших редакций |
| Форматы | Распределение по расширениям, включая архивы и вложенные архивы | Определяет объём работ по конвейеру загрузки |
| Права доступа | Как устроены сейчас: на уровне папок, ролей, отдельных документов | Переносится в систему целиком, спроектировать заново не выйдет |
| Скорость прироста | Сколько документов добавляется в месяц | Определяет требования к регулярной доиндексации |
Считать нужно по каждому источнику отдельно. Корпоративный архив почти никогда не один: СЭД, файловые шары подразделений, почтовые вложения, отдельные хранилища проектной документации. У каждого свои права, свои версии и своё качество.
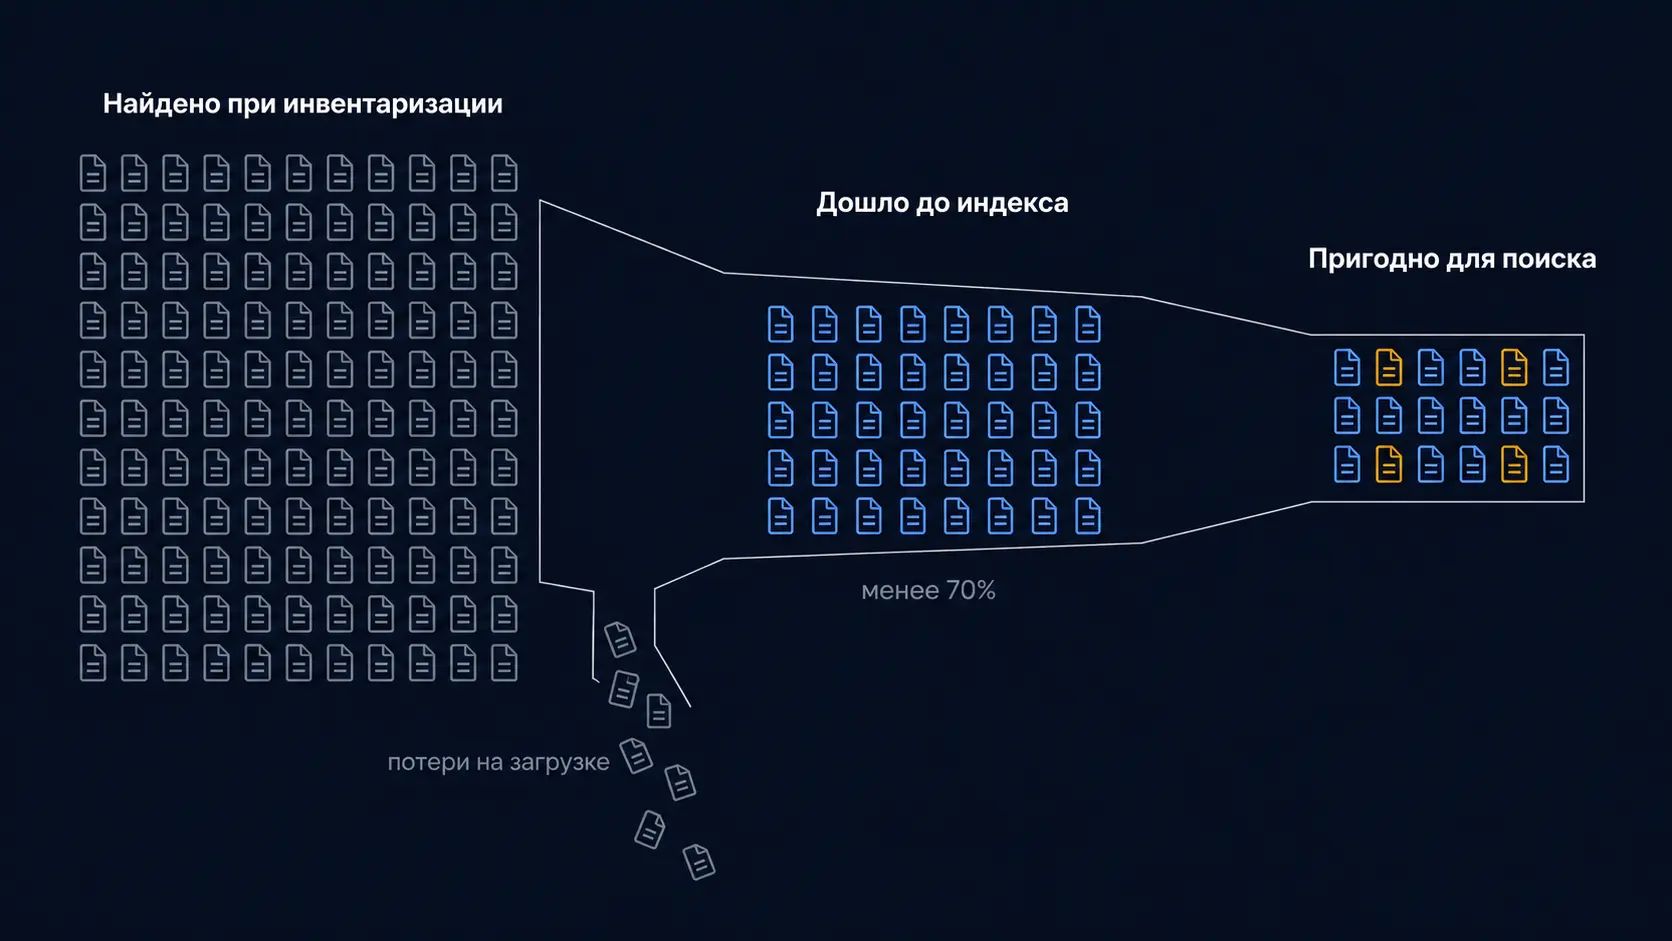
Самый недооценённый параметр в таблице — доля документов, которые не дойдут до индекса. В среднем по пяти внедрениям до индекса с извлечённым текстом добиралось 73% файлов: больше четверти того, что нашлось при инвентаризации, терялось по дороге. Файлы падают на разборе, оказываются архивами внутри архивов, лежат в форматах, которые никто не заложил в конвейер.
Опасность в том, что этого не видно из интерфейса: система работает, поиск отвечает, пользователи довольны. Они просто не знают о документах, которых для системы не существует.
Пять признаков, что корпус ещё не готов
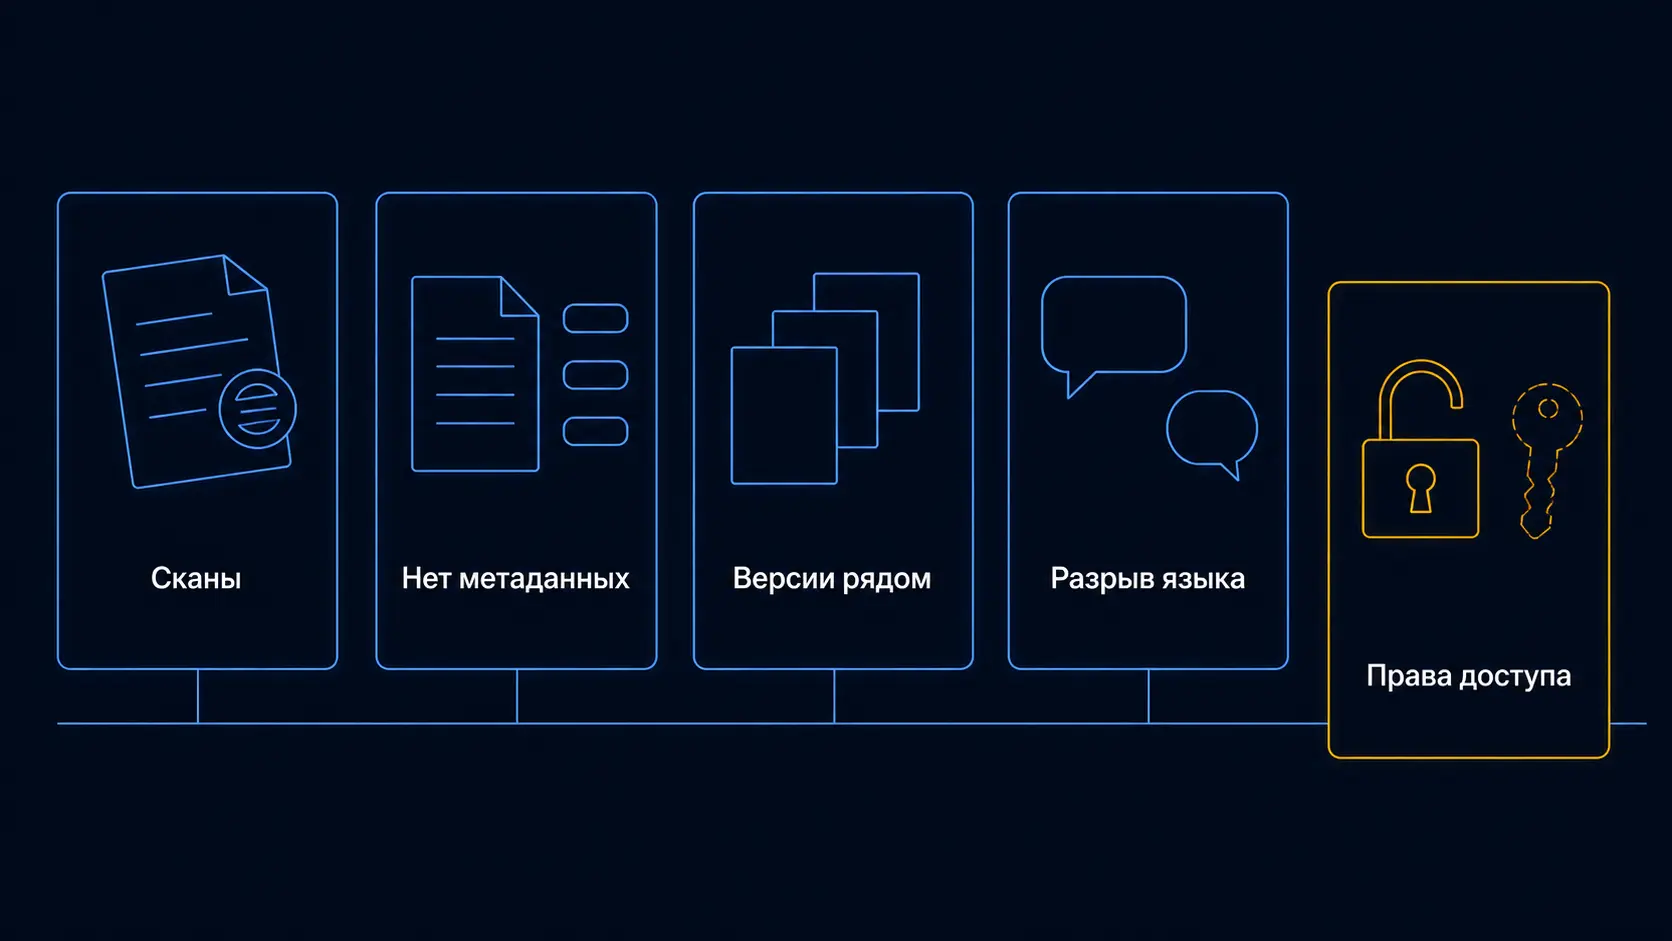
Каждый встречался в большинстве разборов, часть — на всех пяти проектах.
Сканы без надёжного текстового слоя. Договор 2014 года, отсканированный под углом, с печатью поперёк реквизитов и рукописной пометкой на полях. Рядом — его же вторая копия, снятая другим сотрудником и другим сканером. В среднем по пяти внедрениям больше 20% сканов выглядело примерно так — доля от числа отсканированных документов, не от всего архива. Полностью автоматически это не чинится: часть документов остаётся в статусе «найдено, но текст ненадёжен», и пользователю такой статус лучше показывать явно.
Документы без разметки. Всё, что оцифровывалось до появления регламента именования, приходит без даты, автора, подразделения и статуса. Отфильтровать выдачу по правам доступа или отделить действующую редакцию от утратившей силу на таком материале нечем. Восстановить автоматически удаётся немного: номер и дату договора, стороны, тип документа система вытаскивает из текста, остальное приходится добирать из места хранения и журналов СЭД.
Версии, лежащие рядом. _final, _final2, _испр, _испр_окончательный — в одной папке, с разницей в полгода. Поиск найдёт версию двухлетней давности с той же вероятностью, что и действующую, пока не сделана дедупликация по нормализованному тексту и пока актуальная редакция не помечена явно.
Разрыв между языком документов и языком запросов. Документ называется «Регламент взаимодействия при согласовании договорных обязательств», сотрудник спрашивает «как подписать контракт с новым поставщиком». На первых демонстрациях этого не видно, потому что демонстрируют на удобных вопросах.
Права доступа, которых никто не описал. Формально они есть — в виде наследования от папок и списков, накопленных за годы. Фактически на вопрос «кто из сотрудников что должен видеть» внятного ответа обычно нет ни у ИТ, ни у владельцев документов. Это единственный признак из пяти, который не чинится техникой: пока решение не принято на стороне заказчика, разграничение в системе построить не из чего.
Замер точки отсчёта
Прежде чем замерять, стоит выяснить, как поиск устроен фактически. Заказчик обычно уверен, что он работает: в СЭД есть полнотекстовый индекс, у файловых шар понятная структура папок. Через две недели наблюдений выясняется, что маршрут другой.
Сотрудник сначала вспоминает, в каком проекте или году появился документ. Потом идёт в папку подразделения. Не найдя — пишет коллеге, который вёл этот договор. Если коллега уволился — обращается в архив и ждёт. Ни один шаг этого маршрута не виден в журналах СЭД, поэтому замер по журналам нужно дополнять наблюдением за двумя-тремя сотрудниками в течение обычной рабочей недели.
Без baseline любое обсуждение результата сводится к «мне кажется, стало лучше». Замерять стоит две вещи: медианное время поиска документа и долю запросов, которые заканчиваются обращением к живому человеку. Вторая метрика переводится в человеко-часы напрямую и лучше первой работает в разговоре с финансовым блоком.
Способ замера важнее самой цифры. Baseline, собранный опросом пользователей, систематически завышен: люди помнят тяжёлые случаи и не помнят десяток быстрых. Если есть журналы СЭД и заявок в архив — считайте по ним.
Отдельно стоит зафиксировать то, что в человеко-часах не измеряется: работу, сделанную по устаревшему документу. На двух проектах из пяти именно такие эпизоды были главной причиной интереса к теме, и оба раза речь шла не о скорости. В одном случае подразделение отработало по редакции регламента, отменённой полугодом раньше; в другом — согласование ушло по шаблону договора, который юристы давно заменили. Такие истории обычно и двигают проект дальше пилота, поэтому их стоит собрать до старта, пока они ещё свежи в памяти.
Эталонный набор вопросов
Это самая дешёвая часть подготовки и самая пропускаемая. Нужно собрать реальные формулировки от людей из подразделения — с заранее известными правильными документами. Несколько десятков вопросов достаточно для пилота.
Три требования к набору. Вопросы формулируют пользователи, не проектная команда: команда невольно пишет так, как удобно системе. Набор заполняется до того, как кто-либо увидел первую выдачу, иначе он подстроится под наблюдаемое поведение. И в него обязательно попадают неудобные случаи — документы с похожими названиями, вопросы на границе двух регламентов, запросы к документам, которых в корпусе нет.
Последнее нужно, чтобы проверить поведение системы при отсутствии ответа. На двух проектах разрыв между тем, что показывали на демонстрации, и результатом на эталонном наборе оказался достаточным, чтобы пересмотреть стратегию нарезки документов на фрагменты.
Метрики, которые фиксируются до старта
| Метрика | Что показывает | Ориентир по пяти внедрениям |
|---|---|---|
| Покрытие корпуса после загрузки | Доля документов, дошедших до индекса | 73% (среднее по пяти) |
| Релевантность Top-3 | Доля вопросов эталонного набора с нужным документом в первых трёх | 70% (среднее по пяти) |
| Релевантность Top-5 | То же для первых пяти | 85% (среднее по пяти) |
| Доля ответов со ссылкой на источник | Проверяемость выдачи | — |
| Медианное время поиска документа | Сравнение с тем же замером до внедрения | 20% от прежнего |
| Скорость индексации | Планирование первичной загрузки | — |
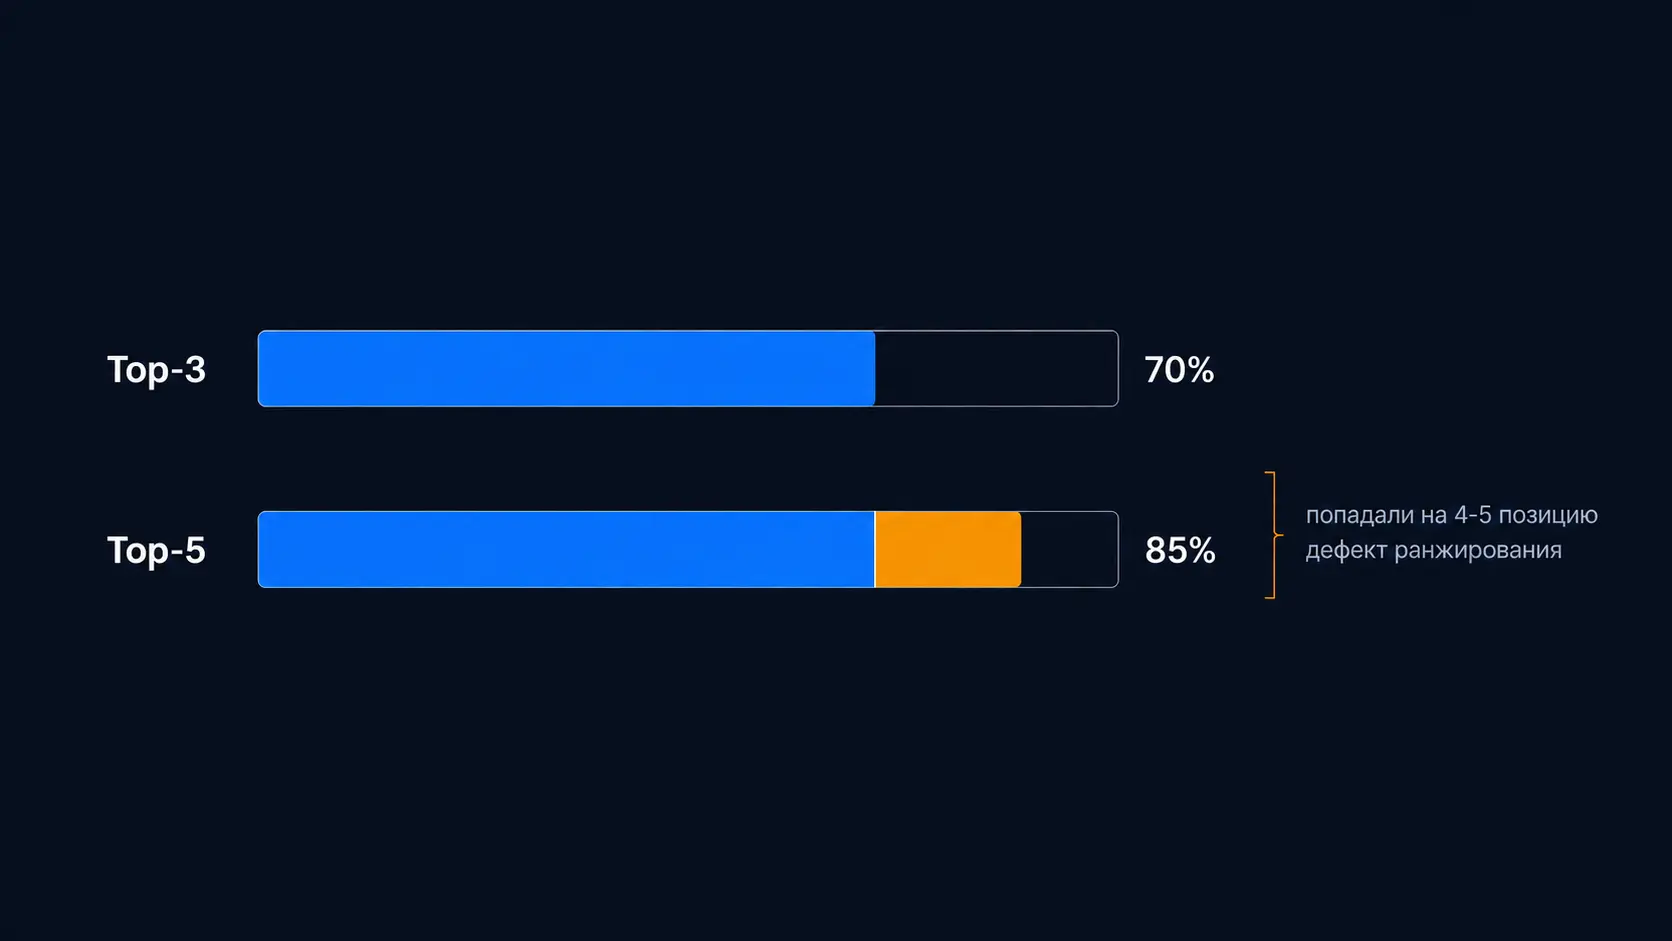
Разрыв между двумя строками с релевантностью говорит больше, чем каждая по отдельности. Пятнадцать пунктов приходятся на две позиции — четвёртую и пятую. Каждый седьмой правильный документ система находила, но ставила ниже той строки, до которой обычно доходит взгляд. Это дефект ранжирования, не поиска: нужный фрагмент достали, поднять наверх не смогли.
Отсюда два следствия. Переранжирование на таком профиле даёт быстрый выигрыш, потому что чинить нужно последний шаг конвейера. И выдачу нельзя обрезать тремя результатами: на трёх позициях терялось бы 15% ответов, которые система в действительности знает.
Считается релевантность по документам, дошедшим до индекса, а дошло 73%. Для пользователя, чей документ попал в потерянную четверть, ранжирование не имеет значения: система не находит ничего в ста процентах случаев. Если эталонный набор составлялся по документам, заведомо присутствующим в индексе, две цифры перемножаются: от исходного корпуса в первых трёх позициях оказывается порядка половины запрошенного. Свой набор на этот счёт стоит проверить раньше, чем цифра попадёт в отчёт руководству.
Значения посчитаны по пяти проектам и не описывают ни одно внедрение по отдельности. Расхождение между проектами объяснялось качеством исходных документов: на архивах из электронных оригиналов покрытие выходило на плато за первые недели, на архивах со сканами тот же уровень занимал заметно дольше.
Одно правило стоит вводить с первого дня, и оно дешевле любых доработок ранжирования: система не отвечает без ссылки на источник. Если релевантных фрагментов нет — сообщает, что не нашла, и предлагает переформулировать. Первый уверенный ответ без источника обходится дороже десяти верных: человек, которому один раз выдали отменённую редакцию как действующую, возвращается к звонку коллеге и больше не возвращается обратно.
Что видно через полгода эксплуатации
Цифры ниже — средние по пяти внедрениям, замер через шесть месяцев после запуска. Ни одна из них не описывает отдельный проект.
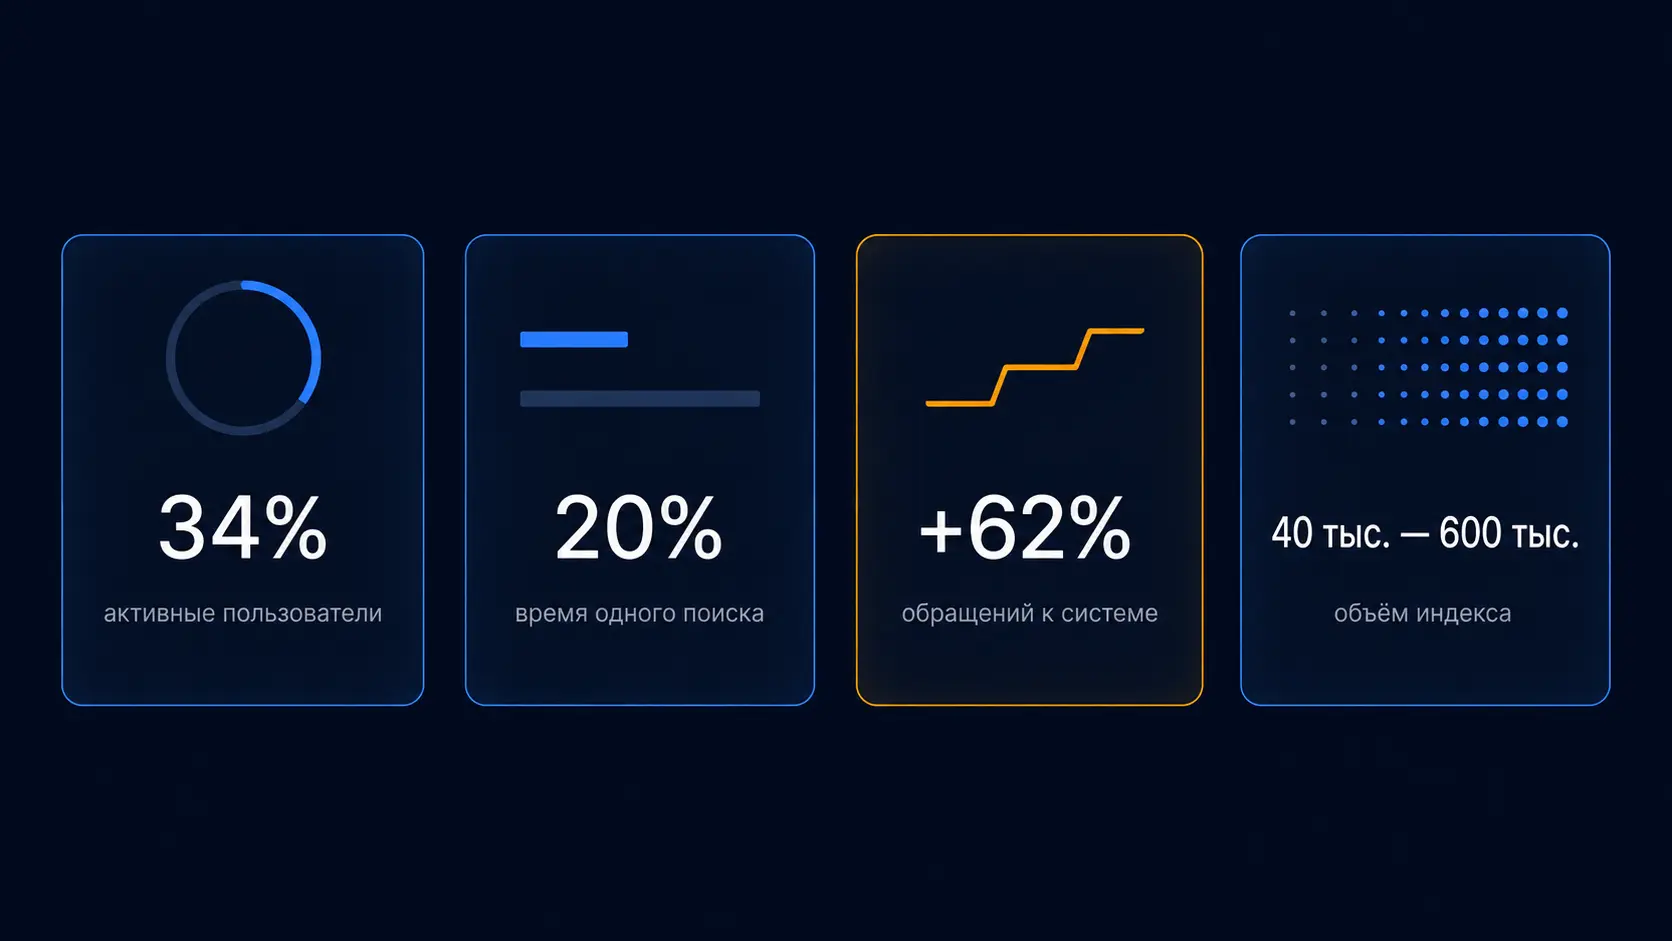
Активными пользователями остались 34% целевой группы — тех, кому выдали доступ и кого учили им пользоваться. Это нормальный результат, и в публичные кейсы он попадает редко. Ожидание, что искать через новую систему будут все, не сбывается: часть сотрудников обращается к документам раз в квартал, часть продолжает пользоваться привычным маршрутом, пока он работает.
Один поиск стал занимать 20% прежнего времени. База сравнения здесь важнее самой цифры: это не бумажный архив, а уже работавшие электронные системы хранения. С бумажного старта число вышло бы крупнее и куда менее показательным.
Число обращений к системе за то же полугодие выросло на 62%. Это метрика вовлечённости, и прочитать её легко неправильно. Люди стали искать чаще, потому что искать стало дёшево: запросы, от которых раньше отказывались — «проще спросить у Сергея», «обойдусь без этого документа», — вернулись в работу.
Отсюда арифметика, которую стоит проговорить с финансовым блоком заранее. Экономия на одном поиске — 80%. Суммарное время, которое подразделение тратит на поиск, сократилось примерно до трети от прежнего — не до пятой части, потому что обращений стало в полтора раза больше. Разрыв между этими двумя цифрами — не потеря. Это подавленный спрос, которого до внедрения не было видно в отчётности, и в бизнес-кейсе его лучше показать сразу, чем объяснять на защите результатов.
Объём индекса за то же полугодие вырос с 40 тысяч документов до 600 тысяч. Эта метрика отвечает на вопрос, который редко задают вслух: дошёл ли проект от пилотной выборки до реального архива или остался жить на первом подразделении. Пятнадцатикратный рост означает, что дошёл — но означает и то, что через полгода в системе лежит корпус, который никто целиком не просматривал. Именно здесь начинает работать роль владельца корпуса.
Роли на стороне заказчика
Оценка корпуса упирается в людей быстрее, чем в технику. Работающий состав на наших проектах включал три роли.
Владелец документов — человек, который знает, какая версия регламента действующая, и имеет право это решать. Представитель ИБ, который согласует контур и схему разграничения доступа; подключать его после проектирования архитектуры дороже, чем на этапе оценки. И группа пользователей, которые ищут документы каждый день и готовы еженедельно смотреть на выдачу. Там, где третьей роли не было, проект доходил до демонстрации и останавливался.
Отдельно — роль на эксплуатацию, которую стоит назвать заранее, хотя понадобится она позже. Кто-то должен отвечать за корпус: подключать новые источники, следить, чтобы свежие документы попадали в индекс, разбирать жалобы на выдачу. Там, где роль не назначили, система деградировала предсказуемо: индекс отставал от реальности, пользователи возвращались к прежним маршрутам.
Технические сбои на пилоте закладываются в план и обычно проходят по нему. Дороже обходились срывы другого рода — ожидание выделения вычислительных ресурсов, смена ответственного на стороне заказчика, пересмотр модели угроз в середине проекта. Ни один из них не связан с моделью или архитектурой, и ни один не лечится наймом более сильной команды разработки.
Контур и правовые ограничения
Их разумнее выяснить на этапе оценки, а не при защите архитектуры. Корпоративный архив производственного холдинга — это договоры с контрагентами, техническая документация, кадровые документы, переписка. Персональные данные там есть всегда, коммерческая тайна почти всегда, у части заказчиков документы попадают в контур объектов КИИ.
Передача такого массива во внешний сервис требует правовых оснований, которых у заказчика обычно нет: согласия субъектов такой сценарий не покрывают, режим коммерческой тайны ограничивает круг лиц, а в аттестованных сегментах исходящие соединения к внешним сервисам либо закрыты принятыми решениями по защите, либо требуют пересмотра модели угроз и переаттестации — по срокам это сопоставимо с самим проектом. Подробнее — в материале про 152-ФЗ и внедрение ИИ.
Про регулирование ИИ: обязанности, установленные 243-ФЗ, адресованы разработчикам и поставщикам больших фундаментальных моделей, корпоративная RAG-система на чужой модели напрямую под них не подпадает. Но исключение из авторского права для обучения на данных работает только для суверенных и национальных моделей — это меняет расклад для тех, кто планирует дообучение на собственном корпусе. Разбор — в статье про обучение ИИ на данных и авторское право.
На уровне архитектуры из этого следует одно практическое требование: фильтрация по правам работает на этапе поиска, до того как фрагмент попадёт в промпт. Если разграничение реализовано только в интерфейсе, его нет. Устройство самого конвейера разобрано в материале про RAG-архитектуру для корпоративных данных.
Что должно быть на выходе
Оценка считается завершённой, когда собраны: инвентаризация по каждому источнику, доля сканов и оценка качества текстового слоя, оценка доли документов без метаданных, схема прав доступа с ответом на вопрос «кто что должен видеть», baseline по времени поиска и обращениям к людям, эталонный набор вопросов и назначенные роли.
С этим набором разговор о сроках и бюджете становится предметным. Порядок цифр по бюджету разобран в материале про стоимость внедрения LLM on-premise; без результатов оценки любая смета будет отличаться от факта в разы, причём в предсказуемую сторону.
Первый сценарий стоит брать узкий: один-два типа документов, одно подразделение, понятный набор пользователей. Пилот на всём массиве стоит дороже и отвечает на тот же вопрос.
И одно ожидание стоит выровнять до старта, потому что позже это делать больно. Пилот не показывает, как система поведёт себя на полном архиве: разброс качества документов на выборке почти всегда меньше, чем на всём массиве. Он не показывает эксплуатационную нагрузку, потому что за несколько недель корпус не успевает устареть. И он ничего не говорит о том, будут ли люди пользоваться системой через год. Всё это нормально ровно до момента, когда результаты пилота уходят наверх как результаты внедрения.
Выводы
- —Качество RAG-поиска определяется состоянием корпуса, а не выбором модели: на всех пяти внедрениях основные доработки пришлись на загрузку, метаданные и версионность.
- —Покрытие корпуса важнее релевантности на старте. Документы, не дошедшие до индекса, пользователь не увидит и о них не сообщит.
- —Baseline и эталонный набор вопросов собираются только до пилота. Задним числом они не восстанавливаются, а без них результат нечем подтвердить.
- —Права доступа — единственный признак неготовности, который не чинится техникой. Решение принимает заказчик, и лучше до начала проекта.
- —Роль владельца корпуса назначается на старте, хотя работать начнёт через полгода. Без неё индекс отстаёт от реальности за несколько месяцев.
- —Следующий шаг — инвентаризация по таблице выше. Она занимает несколько дней и отвечает на большинство вопросов, которые иначе всплывут на третьем месяце пилота.
Частые вопросы
С чего начинать внедрение RAG?
С оценки корпуса, до выбора модели. Нужно понять объём архива, долю сканов, состояние метаданных и схему прав доступа. Эта работа занимает несколько дней и определяет реалистичные сроки пилота.
Сколько занимает пилот RAG?
Срок сильно зависит от состояния документов: электронные оригиналы с метаданными индексируются быстро, массив старых сканов требует отдельного этапа подготовки. Реалистичный горизонт становится понятен после оценки корпуса, до неё любая оценка сроков будет условной.
Работает ли поиск на отсканированных документах?
Работает, но качество распознавания становится отдельным этапом проекта. Печати поверх текста, рукописные пометки и перекос при сканировании снижают точность. Часть документов остаётся с ненадёжным текстовым слоем, и это стоит показывать пользователю явно.
Данные остаются в контуре компании?
Да. Развёртывание идёт на инфраструктуре заказчика: модель, векторное хранилище и документы не покидают периметр, исходящие соединения к внешним сервисам не требуются. Для аттестованных сегментов это условие обязательное.
Нужно ли дообучать модель на своих документах?
В большинстве случаев нет. RAG подключает документы к модели через поиск, не изменяя её весов. Дообучение имеет смысл при выраженной отраслевой терминологии и требует отдельной правовой оценки источников корпуса.
Есть ли примеры реальных внедрений RAG?
Наблюдения собраны на пяти проектах в производстве и промышленных холдингах. Все они закрыты соглашениями о конфиденциальности, поэтому цифры приводятся усреднённо по пяти внедрениям. Один кейс с деталями по конкретному проекту опубликован отдельно.
Что делать, если архив в беспорядке?
Это нормальное исходное состояние. Разбирать имеет смысл с инвентаризации и одного типа документов на пилоте. Приводить в порядок весь архив до старта не требуется: часть работы делает конвейер загрузки.
Об источнике данных
Числовые ориентиры в материале — средние по пяти внедрениям RAG-поиска по корпоративным архивам в производстве и промышленных холдингах. Проекты закрыты соглашениями о конфиденциальности, поэтому данные приводятся обезличенно и не описывают ни одно внедрение по отдельности. Это наблюдения одного интегратора на небольшой выборке, а не отраслевая статистика.
Рабочая тетрадь: оценка корпоративного архива перед RAG-проектом
PDF, 13 страниц для ИТ-директора и владельца документооборота. Формы инвентаризации по каждому источнику, методика выборочной проверки сканов, протокол замера точки отсчёта, шаблон эталонного набора вопросов и итоговый лист с тремя исходами.
Пройти оценку вместе с командой
Инвентаризация источников, выборочная проверка качества сканов, разбор схемы прав доступа и замер точки отсчёта. На выходе — заполненные формы, эталонный набор вопросов и архитектура пилота в закрытом контуре с реалистичными сроками. Всё описанное выполняется и силами вашего ИТ: методика выложена целиком именно поэтому.