Закон об ИИ в России: как проект Минцифры стал 243-ФЗ
Что из спорных норм мартовской редакции дошло до подписанного текста, что убрали и что это значит для госсектора, КИИ и регулируемых отраслей
18 марта 2026 года Минцифры опубликовало проект федерального закона об искусственном интеллекте. Через четыре месяца, 26 июля, закон был подписан — как Федеральный закон № 243-ФЗ. Между этими двумя датами первую редакцию разобрали по частям, отклонили и переписали, и половина того, чего боялся бизнес весной, в итоговый текст не попала.
Читать эту историю имеет смысл не из любопытства. Логика, заложенная весной, в законе осталась: риск-ориентированный подход, особый статус для отдельных категорий моделей, ключевая роль ФСТЭК и ФСБ в чувствительных сценариях. Понимание того, откуда взялись формулировки, помогает читать их правильно — и не переносить на итоговый текст страхи, которые к нему уже не относятся.
Дальше — что именно опубликовали в марте, что переписали в апреле, что осталось в подписанном тексте и какие практические выводы из этого следуют для компаний с повышенными требованиями к информационной безопасности. Постатейный разбор итогового текста — в отдельном материале: 243-ФЗ по тексту закона.
Где сейчас закон
Федеральный закон от 26.07.2026 № 243-ФЗ подписан. Основные положения действуют с 1 сентября 2026 года; определения суверенной и национальной больших фундаментальных моделей, обязанности разработчиков и переходная норма части 3 статьи 13 — с 1 марта 2027 года. Даты 1 сентября 2027 года, которая обсуждалась весной, в законе нет. Подзаконных актов и правоприменительной практики на момент обновления материала также нет.
Что произошло: от 18 марта к 27 апреля
Что было опубликовано весной 2026 года
В середине марта на портале regulation.gov.ru появился проект, который Минцифры презентовало как первый системный закон об ИИ в России. До него отрасль регулировалась по кускам: стратегия развития ИИ до 2030 года, ГОСТы, отраслевые методические документы, экспериментальные правовые режимы под отдельные кейсы. Системного документа не было.
В первой редакции появились несколько идей, которые потом стали предметом главных споров. Прежде всего — сама конструкция риск-ориентированного подхода: регулирование тем строже, чем серьёзнее последствия от ошибки модели. Дальше — три новые юридические категории моделей: «суверенная», «национальная» и «доверенная». Отдельной нормой шла обязательная маркировка контента, созданного нейросетью. Главное для бизнеса с КИИ — обязательное использование доверенных моделей в государственных информационных системах и на значимых объектах критической информационной инфраструктуры. Проверять такие модели должны были ФСТЭК и ФСБ.
Публичное обсуждение шло почти месяц, с 18 марта по 15 апреля. К нему подключились более 150 экспертов, представители Роснефти, Россетей, МегаФона, объединённой компании Wildberries и Russ, отраслевых ассоциаций — АПКИТ, АЦП, АЕБ, ТПП, Ассоциации больших данных. Дискуссия получилась громкой.
Что критиковал бизнес
Камнем преткновения стали критерии «суверенной» и «национальной» моделей. По первой редакции, чтобы получить такой статус, модель должна была разрабатываться исключительно гражданами РФ на территории страны, обучаться только на данных российского происхождения и использоваться только при участии российских юридических лиц. На бумаге звучит логично. На практике — почти невыполнимо.
Открытых русскоязычных датасетов в нужном объёме просто нет. Все российские LLM — и коммерческие, и опенсорсные — используют зарубежные библиотеки, веса базовых моделей и многоязычные датасеты. По оценкам ассоциаций, реализация в первоначальной редакции увеличила бы стоимость внедрения ИИ на 20–40% и замедлила вывод продуктов на рынок в полтора-два раза. Ни первая цифра, ни вторая никого не устраивают.
23 апреля точку в первой редакции поставил Совет по кодификации при Президенте: документ отклонили, указав на противоречия с Гражданским кодексом и размытость формулировок.
Что изменилось в обновлённой редакции
Через четыре дня, 27 апреля, аппарат вице-премьера Дмитрия Григоренко публично рассказал, как документ переписали. Ключевые правки:
- требование разрабатывать суверенные и национальные модели исключительно гражданами России — убрано;
- требование обучать такие модели только на данных российского происхождения — убрано;
- статус «суверенной» и «национальной» теперь нужен в первую очередь для возможности господдержки, а не как обязательное условие применения;
- зарубежные ИИ-модели не запрещаются — они могут работать в России при соблюдении российского законодательства и претендовать на статус доверенных, если пройдут проверку безопасности;
- обязательное использование доверенных моделей касается прежде всего госсектора и значимых объектов КИИ;
- для коммерческого софта подтверждение «доверенности» — добровольное.
Принципиальный сдвиг — от общей запретительной рамки к отраслевому порогу. Большая часть коммерческого ИИ остаётся в зоне мягкого регулирования. Жёсткие требования распространяются на госсектор, КИИ и всё, что прямо влияет на безопасность граждан. Для компаний с лицензиями ФСТЭК и ФСБ, которые работают с КИИ-объектами, по сути ничего не поменялось — к ним требования останутся максимальными.
Чем всё закончилось. Госдума приняла закон 8 июля 2026 года, 26 июля он был подписан как № 243-ФЗ. Апрельские смягчения в итоговый текст вошли: требований разрабатывать модель силами только граждан РФ и обучать её только на российских данных в законе нет, а категорию доверенной модели из финальной редакции исключили целиком — вместе с регулированием ЦОД. Остались две категории: суверенная и национальная.
Почему откладывать подготовку не получится
Весной аргумент «текст ещё не финальный, подождём принятия» звучал разумно. Он перестал работать 26 июля: закон подписан, и ждать больше нечего. Отсечка для тех, кого касаются требования к выбору модели, — 1 марта 2027 года.
Логика регулирования из весенних редакций никуда не делась: риск-ориентированный подход, проверка ФСТЭК и ФСБ, локализация обработки данных в значимых сценариях. Эти принципы заложены не только в 243-ФЗ, но и в сопутствующих документах по КИИ, поручениях Президента, отраслевых нормах. Реестр доверенных моделей из рамочного закона выпал. Идея подтверждения соответствия для ИИ в критической инфраструктуре при этом никуда не делась — она обсуждается отдельно от 243-ФЗ, действующей нормы на сегодня нет.
Параллельно ужесточаются требования по доверенным программно-аппаратным комплексам и переходу на отечественное ПО. ИИ-системы попадают в ту же логику — как новый класс информационных систем, к которому применят те же принципы категорирования, защиты и аудита.
Наконец, чисто технически: переехать с публичного облачного ИИ на закрытый контур за месяц-два невозможно. По нашим оценкам, один контур проходит цикл переноса за четыре-семь месяцев без учёта закупки оборудования: сам перенос с переиндексацией — от двух недель до месяца, документация около восьми недель, аттестация объекта информатизации ещё три-пять недель. Портфель из нескольких систем в этот срок не укладывается, а до 1 марта 2027 года остаётся ровно один цикл. Значит, вопрос стоит не про весь портфель: какие сценарии перевести первыми и по каким осознанно принять общий режим. Считать при этом нужно от даты акта ввода в промышленную эксплуатацию назад, а не от сегодняшнего дня вперёд — пошаговый расчёт с обратным отсчётом мы разложили по этапам отдельно.
Риск-ориентированный подход: ключевая идея регулирования
Идея проста: чем серьёзнее последствия от ошибки или сбоя ИИ-системы, тем строже требования к её разработке и эксплуатации. ИИ, который пишет рекламные тексты, и ИИ, который участвует в решении о допуске человека к опасным работам или о выдаче кредита, — это разные истории и разная мера ответственности.
В первом случае хватает общих правил добросовестности: предупредить пользователя, не нарушать законов о рекламе, маркировать сгенерированный контент. Во втором — нужны жёсткие требования к качеству обучающих данных, объяснимости решений, журналированию, защите от взлома и подмены. И это не каприз законодателя — это нормальная инженерная гигиена для систем, ошибка которых стоит дорого.
Подход не уникален для России. Похожая логика лежит в основе европейского AI Act, и её заимствование — правильный шаг. Но российская версия строится не вокруг прав человека (как в ЕС), а вокруг безопасности информационной инфраструктуры. Поэтому в весенних редакциях ключевые роли достались ФСТЭК и ФСБ, а центральным понятием был реестр доверенных моделей. В подписанном тексте реестра нет: его место занял статус суверенной и национальной модели, а проверка безопасности осталась в общей логике требований по защите информации.
Кто попадает в зону повышенного внимания
В обеих редакциях законопроекта уровень контроля растёт там, где ИИ затрагивает чувствительные сферы. Если ваш сценарий хотя бы частично подходит под одно из этих описаний — готовиться придётся всерьёз:
- системы, влияющие на жизнь и здоровье — медицинская диагностика, помощь врачам в принятии решений, управление транспортом и промышленным оборудованием;
- системы, принимающие или существенно влияющие на решения о правах граждан — скоринг, отказ в услугах, подбор кандидатов на работу;
- системы, обрабатывающие данные ограниченного доступа — персональные данные, банковскую тайну, гостайну, охраняемую иную тайну, коммерческую тайну;
- системы, встроенные в критическую информационную инфраструктуру;
- системы, работающие в государственных информационных системах, особенно социально значимых.
Чем больше галочек, тем выше будет потолок требований. Точные критерии разнесения по уровням риска появятся в подзаконных актах, но общая интуиция от этого не изменится.
Почему КИИ и госсектор — первая линия
Регулирование критической информационной инфраструктуры — самая зрелая часть российского правового поля по ИБ. Здесь уже работают 187-ФЗ, приказы ФСТЭК, требования к доверенным программам и базам данных, обновлённые в 2025–2026 нормы. ИИ-системы естественно достраиваются в эту картину — как новый класс информационных систем, к которому применят знакомые принципы: категорирование, защита, контроль, аудит.
В обновлённой редакции это и закреплено: жёсткие требования распространяются прежде всего на значимые объекты КИИ и госсектор. Для остального бизнеса требования заметно мягче, а значит у большинства компаний есть пространство для маневра. Но только если они не работают с банковской тайной, медициной, энергетикой, транспортом или госзаказчиком.
Суверенная, национальная и доверенная модель ИИ
Это, пожалуй, самая запутанная часть законопроекта. Три новых юридических термина похожи между собой, и даже специализированная пресса их регулярно путает. Между тем разница принципиальная: за каждой категорией стоит своя задача регулятора, и для бизнеса важно понимать, какая из них к нему применима.
Как это закончилось. В 243-ФЗ вошли только две категории — суверенная и национальная. Доверенную модель из финальной редакции исключили; сама идея сертификации ИИ для государственных систем перешла в отдельный проект о применении ИИ органами публичной власти, который не принят. Разбор ниже описывает мартовскую конструкцию из трёх категорий: он нужен, чтобы понимать, откуда взялись формулировки статьи 6, и чем «доверенная модель» отличается от того, что осталось. Что именно сохранилось — в материале про статусы суверенной и национальной модели и в разборе судьбы реестра доверенных моделей.
Зачем три категории
Государство параллельно решает две разные задачи. Первая — поддержать развитие отечественных ИИ-моделей: льготное финансирование, преференции в госзакупках, доступ к вычислительным мощностям. Под эту задачу заточены статусы «суверенная» и «национальная». Вторая — гарантировать безопасность ИИ в чувствительных сферах. Под неё — статус «доверенная».
Перед нами две независимые шкалы. Российская модель не обязательно подходит для КИИ — она может быть отечественной, но уязвимой к prompt injection или к утечкам через выдачу. Зарубежная модель не обязательно небезопасна — в обновлённой редакции она тоже может пройти проверку и получить статус доверенной. Если, конечно, провайдер согласится открыть архитектуру и допустить регуляторов к контролю.
Суверенная модель
В первой редакции суверенной называлась модель с полностью российским происхождением: разработка, обучение, инфраструктура, данные, кадры — всё внутри страны. Именно это и стало главным камнем преткновения: на практике обеспечить такую чистоту цепочки сегодня невозможно.
В обновлённой редакции требования смягчили, и в таком виде они дошли до подписанного текста: разработчик — российское юридическое лицо, модель размещена в российских центрах обработки данных, разработчик контролирует изменение характеристик на всех стадиях жизненного цикла. Порядок присвоения статуса отнесён к подзаконным актам, которых пока нет. Смысл статуса при этом остался прежним: это инструмент промышленной политики — доступ к господдержке, к государственным данным и к праву обучаться на охраняемом контенте.
Национальная модель
Похожа на суверенную, но с менее жёсткими требованиями. Где именно проходит граница между двумя статусами — до сих пор неясно. На это ещё в марте обращали внимание эксперты АПКИТ: разница между «суверенной» и «национальной» в первой редакции была размыта настолько, что юристы не могли уверенно отнести модель к той или иной категории. В подписанном тексте граница проведена: национальная модель требует контроля над существенными характеристиками — структурой, программным обеспечением, настраиваемыми параметрами — и допускает чужие компоненты, включая иностранные фундаментальные модели, если они распространяются по открытой лицензии. Разбор обоих статусов — в отдельном материале.
Доверенная модель
В мартовской редакции это было ключевым понятием для всех, кто работает с КИИ, госзаказчиками или чувствительными данными. Модель предполагалось признавать доверенной по четырём критериям одновременно:
- пройти подтверждение соответствия требованиям информационной безопасности — по линии ФСТЭК и ФСБ;
- обрабатывать данные на территории России;
- соответствовать отраслевым требованиям качества — например, требованиям ЦБ для банков или Минздрава для медицинских систем;
- быть включённой в специальный реестр доверенных моделей.
Допуск в государственные информационные системы и на значимые объекты КИИ предполагалось ограничить моделями из этого реестра; по апрельской редакции зарубежная модель тоже могла в него попасть, пройдя проверку. Ни реестра, ни самой категории в подписанном тексте нет — ограничение построено иначе, через статус суверенной и национальной модели и через право Правительства определять случаи их обязательного применения.
Порядок проверки не был утверждён и на конец апреля 2026 года. В подписанном законе процедуры подтверждения статуса тоже нет: порядок отнесён к подзаконным актам, которых на сегодня не существует. Так работает рамочное регулирование — закон задаёт принципы, методики и регламенты приходят следом.
Как это касается вашего бизнеса
Весной ответ на этот вопрос звучал через реестр. Сейчас он звучит проще. Если ИИ-сценарии не пересекаются с госсектором, КИИ или социально значимыми государственными системами, из 243-ФЗ обязанностей не возникает вообще: достаточно общего законодательства — 152-ФЗ о персональных данных, 149-ФЗ об информации, отраслевых норм. Можно работать хоть на YandexGPT, хоть на Claude, хоть на опенсорсной Llama — под свою ответственность.
Если пересекаются — решение упирается не в выбор модели, а в два инфраструктурных факта: где выполняется инференс и где лежат данные вместе с производными — логами промптов, векторами, кэшем генераций. От них зависит попадание системы в переходный период по части 3 статьи 13, а он даёт отсрочку до 1 сентября 2032 года. На практике компании разводят портфель: нечувствительные сценарии остаются во внешних сервисах, всё остальное уходит в закрытый контур, который проще аттестовать.
Иностранные ИИ-сервисы: что меняется на самом деле
В марте, когда первую редакцию законопроекта только опубликовали, в деловой прессе быстро сложилась интерпретация: иностранные ИИ-сервисы запретят. Трактовка оказалась поспешной и не совсем точной — и аппарат Григоренко её прямо опроверг 27 апреля. Полного запрета в законопроекте нет ни в одной редакции.
В весенних редакциях ограничение было устроено через реестр: в значимых объектах КИИ и государственных системах допускались только доверенные модели. В подписанном законе механизм другой. Правительство вправе установить случаи, когда допускается применение исключительно суверенных или национальных моделей, и перечень исключений из таких случаев. Рубильник установлен, но не повёрнут: перечня не существует, а сама норма включается 1 марта 2027 года.
Смысл барьера от смены механизма не изменился. Статус требует российского разработчика, размещения модели в российских ЦОД и контроля над её характеристиками; для национальной модели чужие компоненты допустимы только на условиях открытой лицензии. Проприетарный зарубежный API не проходит по двум основаниям сразу — лицензия закрытая, инференс и хранение данных происходят вне России. Закон отсекает отсутствие контроля, а не происхождение модели, и результат тот же: барьер, через который публичные платформы не пройдут.
Для частного бизнеса, не работающего с КИИ и госзаказчиками, формальных ограничений по использованию зарубежных моделей в 243-ФЗ нет вообще. Можно продолжать работать с ChatGPT, Claude, Gemini и любыми другими — под свою ответственность и при соблюдении общего законодательства.
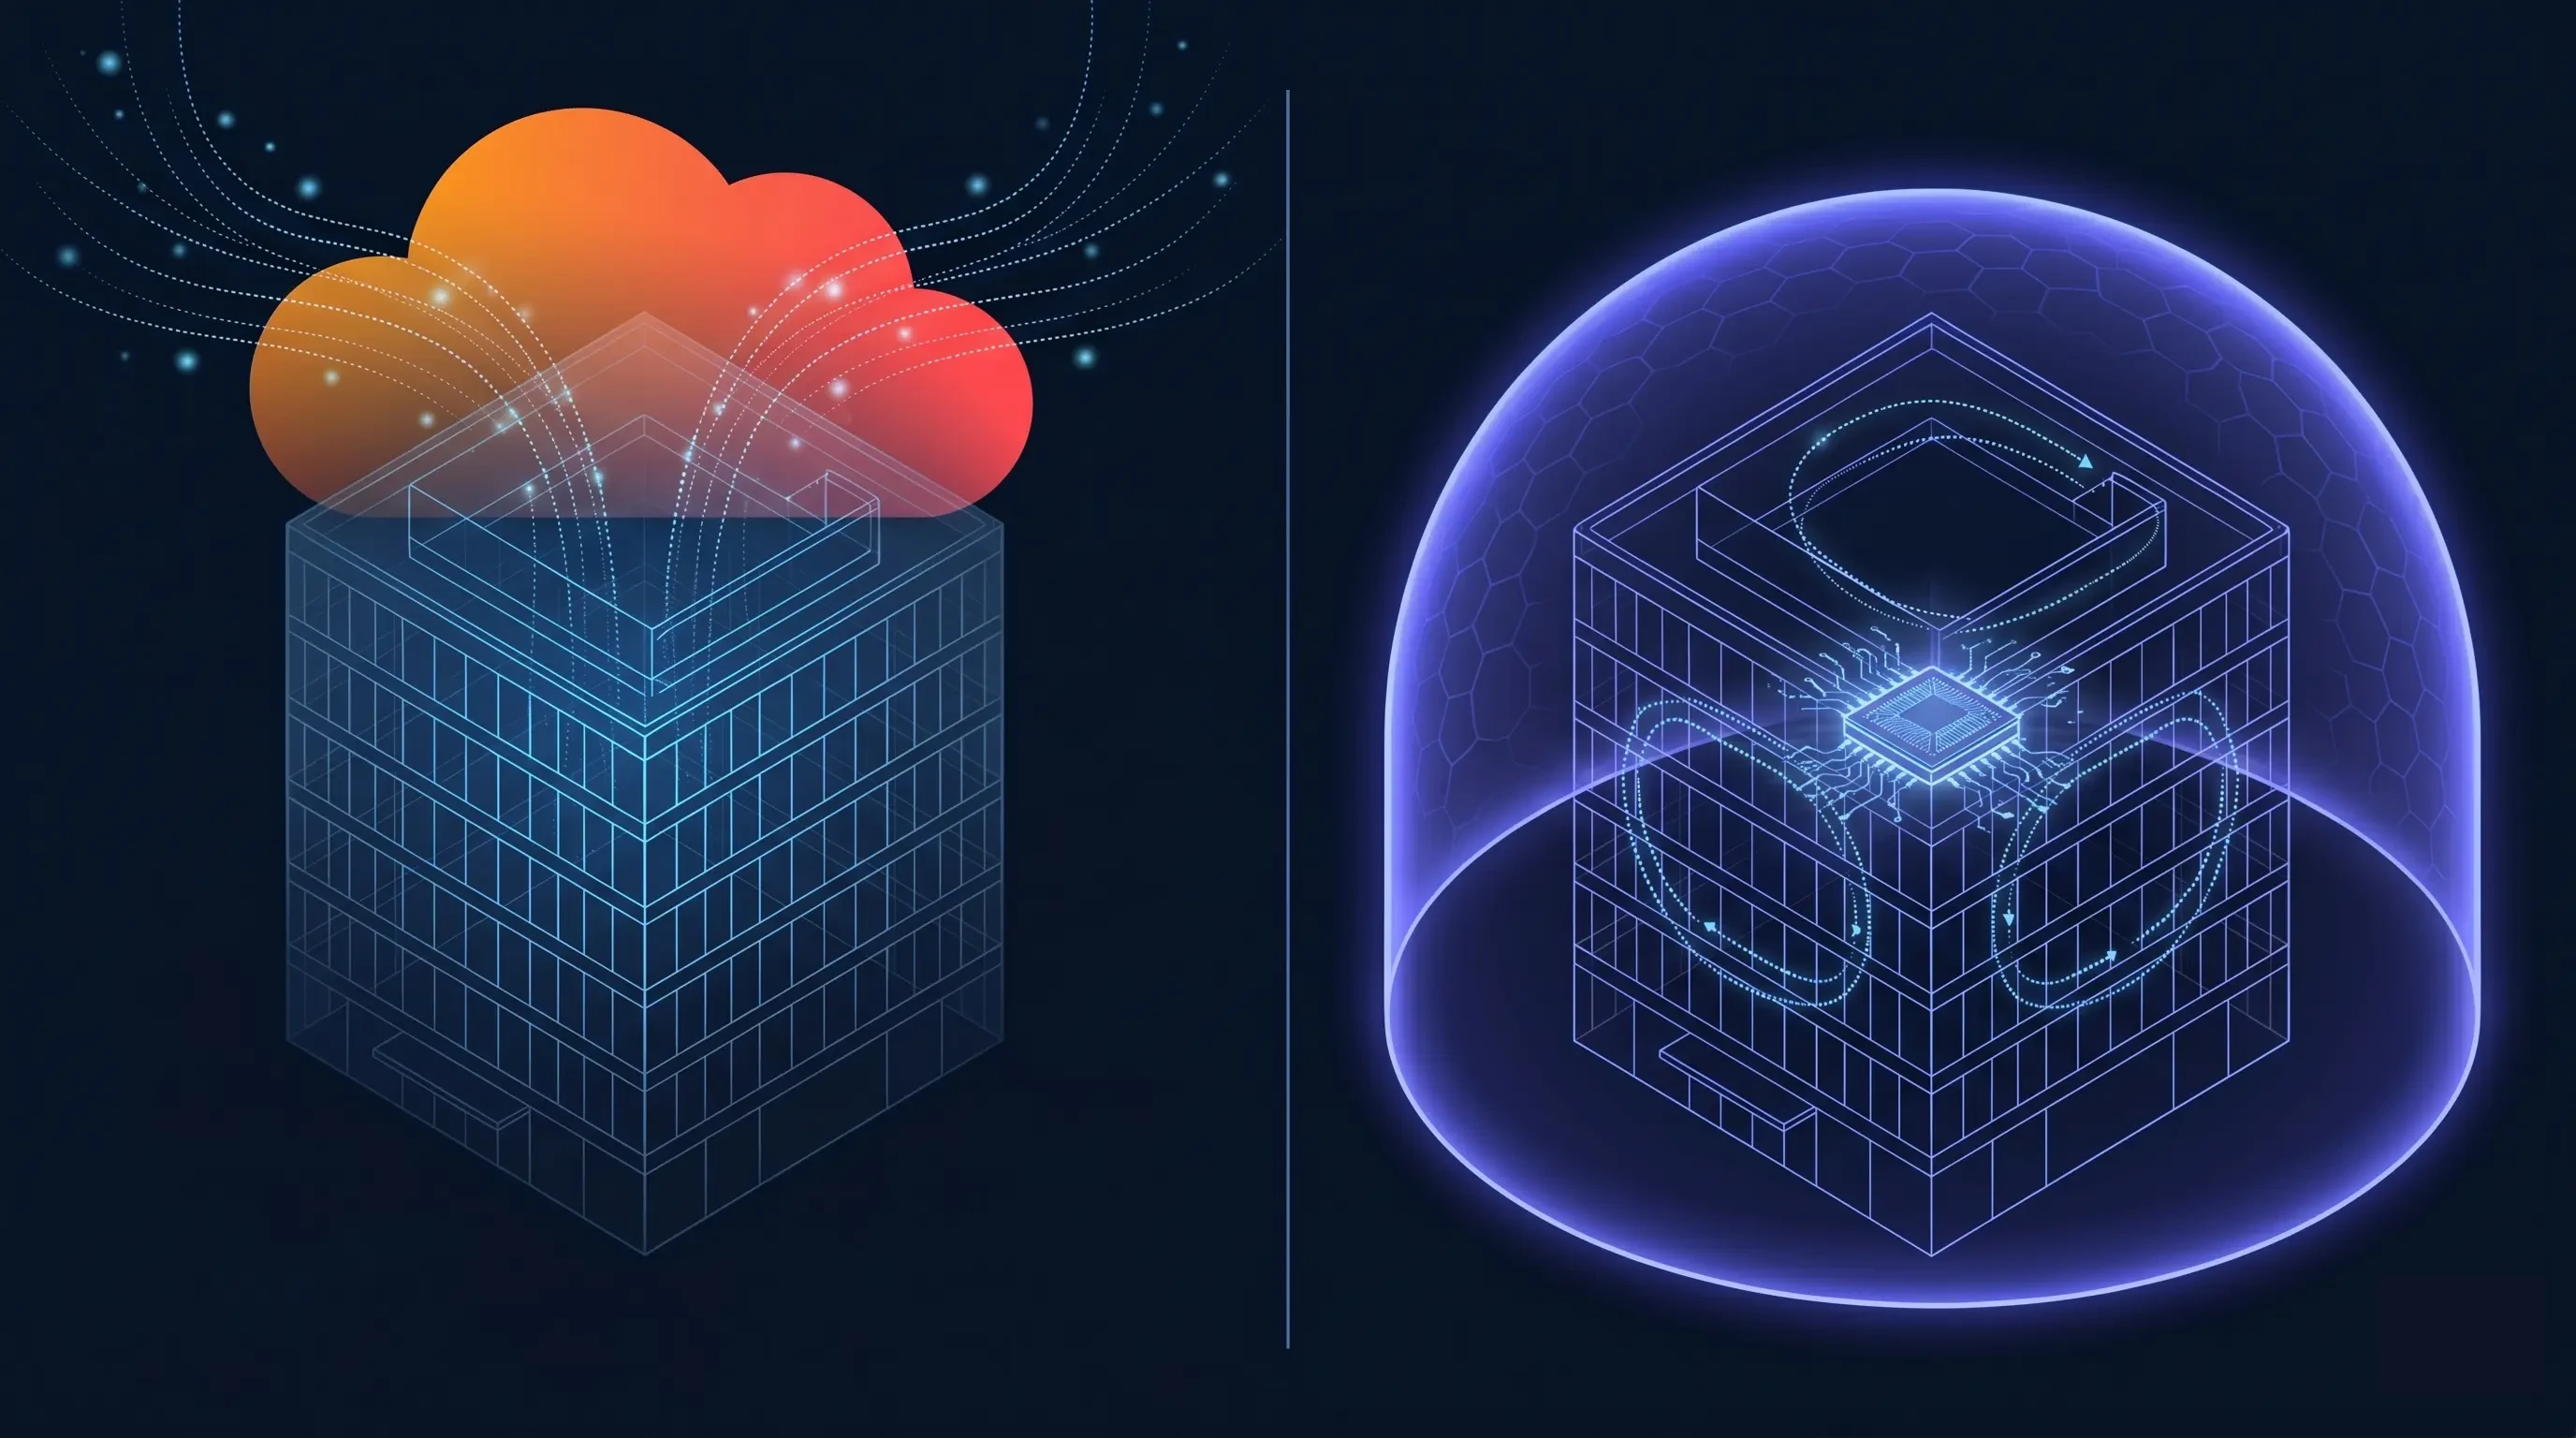
Скрытые риски использования внешних облаков
Закон подписан, но проблемы с публичным облачным ИИ появились не из-за него и никуда не денутся, даже если подзаконные акты выйдут мягкими. Зрелые компании учитывали их и до 243-ФЗ — и переходили в закрытый контур, не дожидаясь принуждения.
- Передача персональных данных за рубеж. Когда сотрудник копирует резюме кандидата в ChatGPT для краткого пересказа — это потенциальное нарушение 152-ФЗ, если у компании нет надлежащих оснований трансграничной передачи. Подробнее о 152-ФЗ и ИИ.
- Утечка коммерческой тайны. Запросы и документы, отправленные в публичный сервис, могут попадать в логи провайдера, использоваться для дообучения модели или быть доступны его сотрудникам в рамках расследований. Юристы спокойно загружают черновики договоров, разработчики — куски кода с ключами API. Никто не считает это утечкой, пока ничего не всплыло.
- Геополитические риски. Провайдер может в любой момент отозвать доступ или ограничить использование — такие случаи уже происходили с рядом западных сервисов после 2022 года.
- Потеря контроля над данными. В корпоративный DLP внешний облачный сервис не встроишь. Журналирования действий пользователей нет. Аудит после инцидента — невозможен.
- Несовместимость с отраслевыми регуляторами. Банковская тайна, медицинская тайна, гостайна, охраняемая иная тайна — всё это плохо совмещается с публичным облачным ИИ независимо от того, что напишут в ФЗ об ИИ.
Список не исчерпывающий, и каждый пункт по отдельности кажется управляемым. Проблема в том, что они часто складываются: одно резюме в ChatGPT — ничего страшного, тысяча резюме в ChatGPT — уже подходящий повод для предписания Роскомнадзора.
Сертификация, ФСТЭК и ФСБ: что готовить заранее
Что известно про процедуру
Про проверку доверенных моделей в весенних редакциях было сказано немного: ею занимаются ФСТЭК и ФСБ, обработка данных идёт на территории России, модель отвечает отраслевым требованиям качества и попадает в реестр. В подписанном законе этой процедуры нет вовсе. Обязанности статьи 8 адресованы разработчикам моделей со статусом и сводятся к трём вещам: организационные и технические меры безопасности модели, правила эксплуатации, техническая документация с ключевыми параметрами и ограничениями. Порядок подтверждения статуса отнесён к подзаконным актам.
Конкретные регламенты — методики, критерии, формы документов, сроки рассмотрения, состав испытаний — уйдут в подзаконные акты, которые появятся уже после принятия закона. Так работает рамочное регулирование: закон задаёт принципы, методики приходят отдельно. Минус в том, что готовиться к конкретике приходится по аналогиям с уже существующими процедурами ФСТЭК и ФСБ.
Какие документы стоит готовить уже сейчас
Подзаконные акты ещё не написаны, но базовый комплект документов от их нюансов почти не зависит. Если в компании есть ИИ-сценарии в чувствительных сферах, готовить нужно следующее.
- Модель угроз ИИ-системы. Не обычная модель угроз, а специфичная для нейросетей: отравление обучающих данных, prompt injection, утечка чувствительной информации через выдачу модели, подмена компонентов цепочки поставки, инверсия модели для извлечения обучающих данных. Без неё ни одна проверка не закроется.
- Классификация обрабатываемых данных. Что именно идёт на вход и выход модели: персональные данные, коммерческая тайна, охраняемая иная тайна, банковская тайна, гостайна. Без классификации невозможно ни оценить риск, ни выбрать архитектуру.
- Архитектурная схема. Где живёт модель, где данные, как они движутся, кто имеет доступ. Картинка простая, но именно её всегда требуют первой.
- Регламенты эксплуатации. Порядок обновления модели, контроль изменений, тестирование перед каждой выкаткой. Если завтра прилетит новая версия Llama 4 и кто-то на коленке заменит ей старую модель в продакшене — это нарушение.
- Журналирование действий пользователей и модели. Запросы, ответы, решения, время хранения, защита самих журналов. Особенно важно для расследования инцидентов.
- Контроль доступа. Кто может работать с системой, как аутентифицируется, какие у него права. Простая ролевая модель закрывает 80% вопросов.
- Управление инцидентами. Что считается инцидентом ИИ (не всегда очевидно: утечка через выдачу — это инцидент или сбой?), как фиксируется, кому эскалируется, как расследуется.
- Контроль цепочки поставки. Откуда взялись веса модели, какая лицензия, чем отличается версия в проде от опенсорсной, кто и когда дообучал.
Этот пакет — фундамент любой проверки, и готовить его нужно не под 243-ФЗ. Приказ ФСТЭК России от 11.04.2025 № 117, заменивший семнадцатый приказ, действует с 1 марта 2026 года и уже содержит отдельное требование о защите информации при использовании искусственного интеллекта — включая положение о том, что сведения из государственной информационной системы не могут быть основой для обучения модели. То есть часть работы регулятор потребовал раньше, чем вышел закон об ИИ. Подробнее о сценариях ИИ в информационной безопасности.
Контроль цепочки поставки моделей
На этом пункте стоит остановиться отдельно. Supply chain ИИ-системы — тема молодая, и в корпоративных регламентах она почти никогда не прописана достаточно подробно. Между тем именно через цепочку поставки происходят самые неочевидные инциденты.
Что нужно отслеживать: источник самой модели (кто обучал, на каких данных, по какой методике), источник весов и контрольные суммы, версии библиотек и фреймворков (PyTorch, TensorFlow, vLLM, llama.cpp — у каждого регулярно выходят CVE), образы контейнеров и базовые ОС, внешние API, к которым обращается система во время инференса, и датасеты, использованные для дообучения.
Чем прозрачнее эта цепочка, тем проще пройти проверку и подтвердить «доверенность». Для on-premise решений всё это в принципе выполнимо — компания контролирует каждый компонент. Для публичных облачных моделей — фактически нет: провайдер не покажет вам внутренности своего стека.
Чек-лист подготовки к 1 марта 2027 года
Ждать больше нечего: закон подписан, а подзаконные акты появятся уже поверх него. Ниже — развёрнутый перечень того, что имеет смысл начать делать; сжатый план на квартал с расчётом сроков от отсечки назад собран в отдельном материале. Ни один пункт не зависит от содержания будущих постановлений: это работа по собственной инфраструктуре, которая окупается независимо от того, попадёт ваша отрасль в правительственный перечень или нет.
- Инвентаризация ИИ-сценариев. Где в компании уже используется или планируется ИИ — генеративные модели, видеоаналитика, скоринг, RAG-поиск, ассистенты в продуктах. Список почти всегда длиннее, чем кажется ИТ-директору: половину сценариев запустили подразделения сами, без согласования. Без этой карты дальше двигаться бессмысленно.
- Классификация данных по каждому сценарию. Что подаётся на вход, что выходит, какие категории данных проходят через систему. Персональные, коммерческая тайна, банковская, охраняемая иная, гостайна, открытые. Это основа для всех дальнейших решений.
- Определение уровня риска. По логике риск-ориентированного подхода: что произойдёт при сбое, ошибке или утечке. Сценарии, влияющие на жизнь людей, права граждан или устойчивость КИИ — высокий риск. Внутренний помощник в почте — минимальный.
- Аудит использования внешних ИИ-сервисов. Какие сотрудники работают с публичными моделями, что туда отправляют, есть ли политика. Часть данных при таком аудите всплывает впервые: «Иван из маркетинга три месяца загружал в ChatGPT финансовые отчёты для пересказа на планёрке».
- Запрет загрузки чувствительных данных в публичные модели. Сделать это можно буквально завтра — регламентом, корпоративным DLP, прокси, корпоративным браузером. Большая часть рисков снимается простыми техническими мерами и инструктажем.
- Архитектура для каждого сценария. Публичный облачный ИИ — только для нечувствительных задач. Гибрид — где это допустимо. On-premise или закрытый контур — для всего, что связано с персональными данными в чувствительных сценариях, КИИ, банковской тайной, гостайной.
- ИБ-документация. Модели угроз, регламенты, журналирование, инциденты — всё, что обсуждалось выше. Для подготовленного ИБ-отдела — несколько недель работы. Для тех, кто такой работой раньше не занимался, счёт пойдёт на месяцы.
- Пилот закрытого контура. Если в компании ещё нет опыта on-premise развёртывания LLM или RAG — первый пилот лучше пройти сейчас, в спокойном режиме. Через год это будет нужно делать в авральном. См. пошаговое руководство.
- Обучение сотрудников. Без культуры безопасной работы с ИИ любые технические меры обходятся за пять минут — через копипаст в публичный сервис или личный смартфон. Одним инструктажем такое не решается — нужна системная работа с командами.
- Подготовка к аудиту и аттестации. Понять, кто внутри компании отвечает за это направление (часто — никто), какие подрядчики могут помочь, какие лаборатории работают по линии ФСТЭК и ФСБ. Желательно заранее: аттестационный ресурс ограничен, и ближе к отсечке очередь к хорошим исполнителям вырастет.
Самопроверка ИИ-контура по 243-ФЗ
Закон подписан 26 июля 2026 года, и проверять контур нужно уже по нему. В документе пять шагов с критериями завершения, формы перечня моделей, таблица решений «БФМ или нет», четыре готовые формулировки для внутренних документов и чек-лист на одну страницу. Разбор занимает половину рабочего дня.
Как помогает on-premise развёртывание AZONE-AI
Грамотная подготовка к будущему регулированию — это не «купить сертифицированный продукт». Это значит выстроить архитектуру, которая в принципе совместима с риск-ориентированным подходом. On-premise развёртывание ИИ — один из её ключевых элементов. Не единственный, но для большинства сценариев из «высокого» и «критического» риска — безальтернативный.
Что даёт on-premise архитектура практически:
- Локальная обработка данных. Запросы, документы, ответы остаются в периметре организации. Локальная обработка снимает большую часть вопросов по 152-ФЗ, банковской тайне, охраняемой иной тайне и потенциальным требованиям локализации для доверенных моделей.
- Никакой передачи запросов во внешние облака. Главный риск публичных ИИ-сервисов — решён на уровне архитектуры. Не регламентом, не инструктажем, а тем, что физически некуда отправлять.
- LLM и RAG в закрытом контуре. Языковые модели и корпоративный поиск работают внутри инфраструктуры заказчика. Корпоративные знания не «утекают» в обучение чужой модели.
- Разграничение доступа на уровне корпоративных систем. Аутентификация через AD/LDAP, ролевые модели, ограничение видимости данных по подразделениям.
- Журналирование действий пользователей и модели. Всё, что нужно для расследования инцидентов и аттестационных процедур.
- Интеграция с корпоративными источниками знаний. RAG-архитектура подключается к 1С, СЭД, базам нормативных документов, архивам — без выноса этих данных наружу.
- DLP, SIEM, SOAR — по месту. ИИ-система становится частью корпоративного контура ИБ, а не «чёрным ящиком в облаке поставщика».
- Готовность к будущим требованиям. Когда появятся подзаконные акты с конкретными методиками проверки доверенных моделей, on-premise архитектура изначально совместима с большинством разумных требований — потому что построена по тем же принципам, что и существующие нормы по защите информации.
Ограничение здесь не в архитектуре, а в календаре: аттестационный ресурс конечный, и очередь к лабораториям ближе к отсечке будет длиннее, чем сейчас. Если сценарий должен попасть под отсрочку, считать нужно от даты акта ввода в промышленную эксплуатацию назад, а не от сегодняшнего дня вперёд.
Частые вопросы
Когда вступит в силу закон об ИИ в России?
Закон подписан 26 июля 2026 года как № 243-ФЗ. Основные положения действуют с 1 сентября 2026 года, определения суверенной и национальной моделей и обязанности разработчиков — с 1 марта 2027 года. Дата 1 сентября 2027 года обсуждалась в весенних редакциях проекта и в итоговый текст не вошла.
Кого коснётся ФЗ об искусственном интеллекте?
Предмет 243-ФЗ уже, чем у весенних редакций: закон регулирует большие фундаментальные модели от миллиарда параметров, универсальные и служащие основой для другого ПО. Прикладные системы — скоринг, антифрод, видеоаналитика — под предмет не подпадают. Подробнее — в материале о пороге в 1 млрд параметров.
Что такое риск-ориентированный подход к ИИ?
Это принцип, по которому жёсткость регулирования зависит от того, какой ущерб может нанести ИИ-система при сбое или некорректной работе. Бытовые сценарии регулируются мягко, ИИ для КИИ и решений, влияющих на жизнь и права людей, — строго.
Что такое доверенная модель ИИ?
Это категория из весенних редакций законопроекта: модель, прошедшая проверку по линии ФСТЭК и ФСБ, обрабатывающая данные на территории России, отвечающая отраслевым требованиям качества и внесённая в специальный реестр. В подписанном 243-ФЗ такой категории нет — её исключили вместе с реестром. Действующие статусы — суверенная и национальная модель, они описаны в статье 6 и работают с 1 марта 2027 года.
Будут ли запрещены иностранные ИИ-сервисы?
Прямого запрета в 243-ФЗ нет. Зарубежные модели могут применяться в России при соблюдении российского законодательства. Ограничение работает иначе: правительство вправе определить случаи, когда обязательно применяются суверенные или национальные модели, — а эти статусы предполагают российского разработчика. Перечня таких случаев на момент обновления материала нет.
Что делать компаниям КИИ?
В первую очередь — инвентаризация ИИ-сценариев, классификация данных и фиксация того, где они обрабатываются и хранятся вместе с производными: логами промптов, векторами, кэшем генераций. Параллельно — перевод чувствительных сценариев в закрытый контур с расчётом сроков от 1 марта 2027 года назад. Порядок шагов — в плане на квартал.
Нужно ли уже сейчас переходить на on-premise ИИ?
Если речь о работе с КИИ, банковской тайной, гостайной или персональными данными в чувствительных сценариях — начинать стоит сейчас. Перенос одного контура с аттестацией занимает от четырёх до семи месяцев без учёта закупки оборудования, а до отсечки 1 марта 2027 года остаётся ровно один такой цикл.
Как подготовиться к 243-ФЗ до марта 2027 года?
Базовый порядок: инвентаризация ИИ-сценариев → классификация данных → оценка риска → разделение сценариев между публичным, гибридным и закрытым контуром → подготовка ИБ-документации → пилот закрытого контура → обучение сотрудников → подготовка к проверкам.
Актуальность материала
- История законопроекта описана по состоянию на 27 апреля 2026 года — это датированное наблюдение, а не описание действующей нормы. Итоговый текст закона разобран отдельно: 243-ФЗ по тексту закона.
- Сведения о 243-ФЗ приведены по состоянию на 31 августа 2026 года. Подзаконных актов и правоприменительной практики на эту дату нет.
- Материал не является юридическим заключением.
- Для конкретных сценариев и юридических решений рекомендуется обращаться к юристам, специализирующимся на регулировании ИТ и КИИ.
Готовьте архитектуру к марту 2027 года
За 4–8 недель мы развёртываем on-premise LLM или RAG-ассистента в закрытом контуре заказчика. Лицензии ФСТЭК, ФСБ и МО РФ. Опыт с 2003 года.